アカデミーブログ
Physical AI入門:ロボットが「考えて動く」仕組みと2026年の最前線
2026/11/04
0. はじめに
ChatGPTが文章を書き、画像生成AIが絵を描くようになった次に来るのが、AIが物理世界で体を動かす段階です。これをPhysical AI(フィジカルAI)と呼びます。2025〜2026年にかけて、NVIDIAのCEOがキーノートの主題に掲げ、Google DeepMindやスタートアップが相次いで「ロボットの基盤モデル」を発表し、日本政府も骨太方針で「成長の加速装置」と位置づけました。
弊社、VRプロフェッショナルアカデミーでも、XRに続いて注目している「Physical AI」。
しかし、そもそもPhysical AIとはなんでしょうか?最新技術としてどのようなものが発表されているのでしょうか?そして、Physical AIを事業や職業として始める勝ち筋はどの程度あるのでしょうか?
このnoteでは、そんな「Physical AI」の入門解説を行います。
読み終えるとできること
Physical AIを「技術の積み重ね」として説明できる
VLA・世界モデルなど、ニュースに出てくる用語の位置づけがわかる
2026年時点の主要プレイヤーと、何が解決済みで何が未解決かがわかる
自分で手を動かす最初の一歩がわかる
目次
1. Physical AIとは何か
入力から行動を出すAI
NVIDIAはPhysical AIを、ロボットや自動運転車などの自律機械が、現実世界を知覚し、理解し、複雑な行動を実行するためのAIと説明しています。
言い換えると、以下のようになります。
センサーの入力を受け取り、物理的な行動を出力し、その結果をまた入力として受け取り続けるAI
LLMは「テキストを入れたらテキストが返る関数」として扱えます。Physical AIは関数ではなくループです。
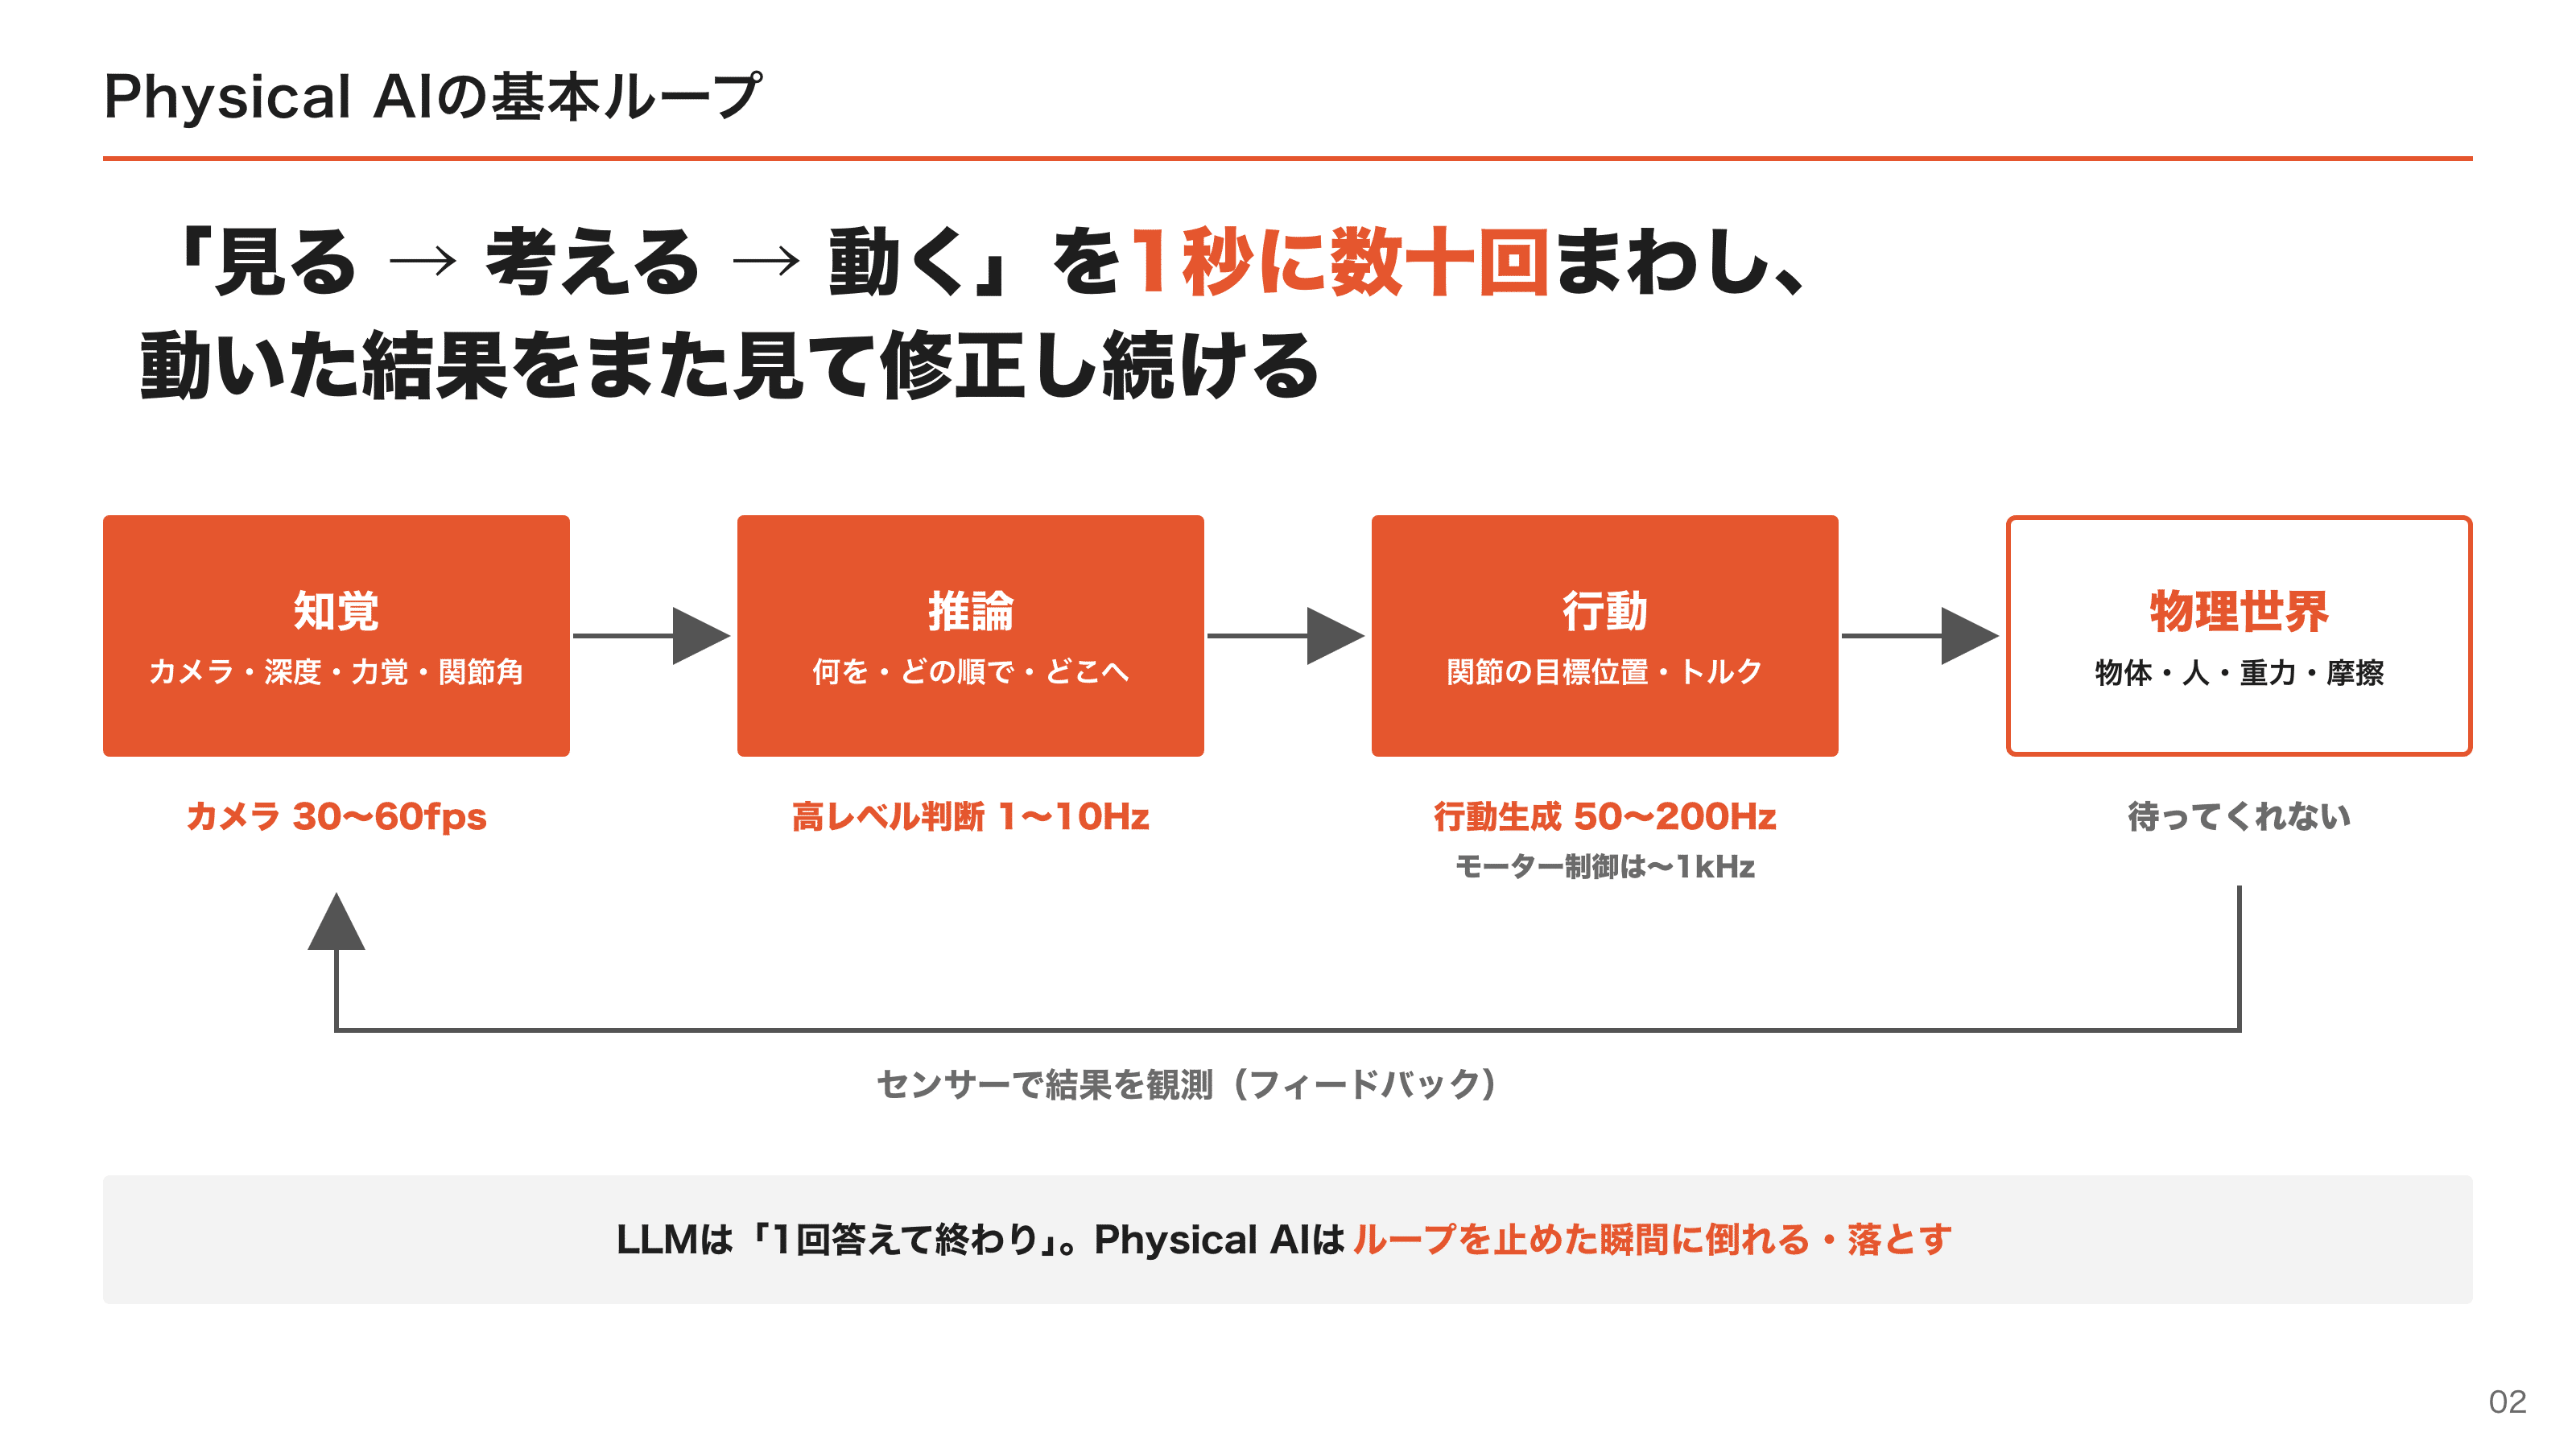
ロボットはカメラで状況を見て、何をすべきかを判断し、関節を動かします。動かした結果、物の位置や自分の姿勢が変わるので、また見て、判断し直します。このループを1秒に数十回まわし続けます。ループが一瞬でも止まれば、二足歩行ロボットは倒れ、つかんだコップは落ちます。
生成AIと何が違う?
「LLMの出力先をロボットに変えればよいのでは」と考えたくなりますが、実際には次の3点で難易度が跳ね上がります。
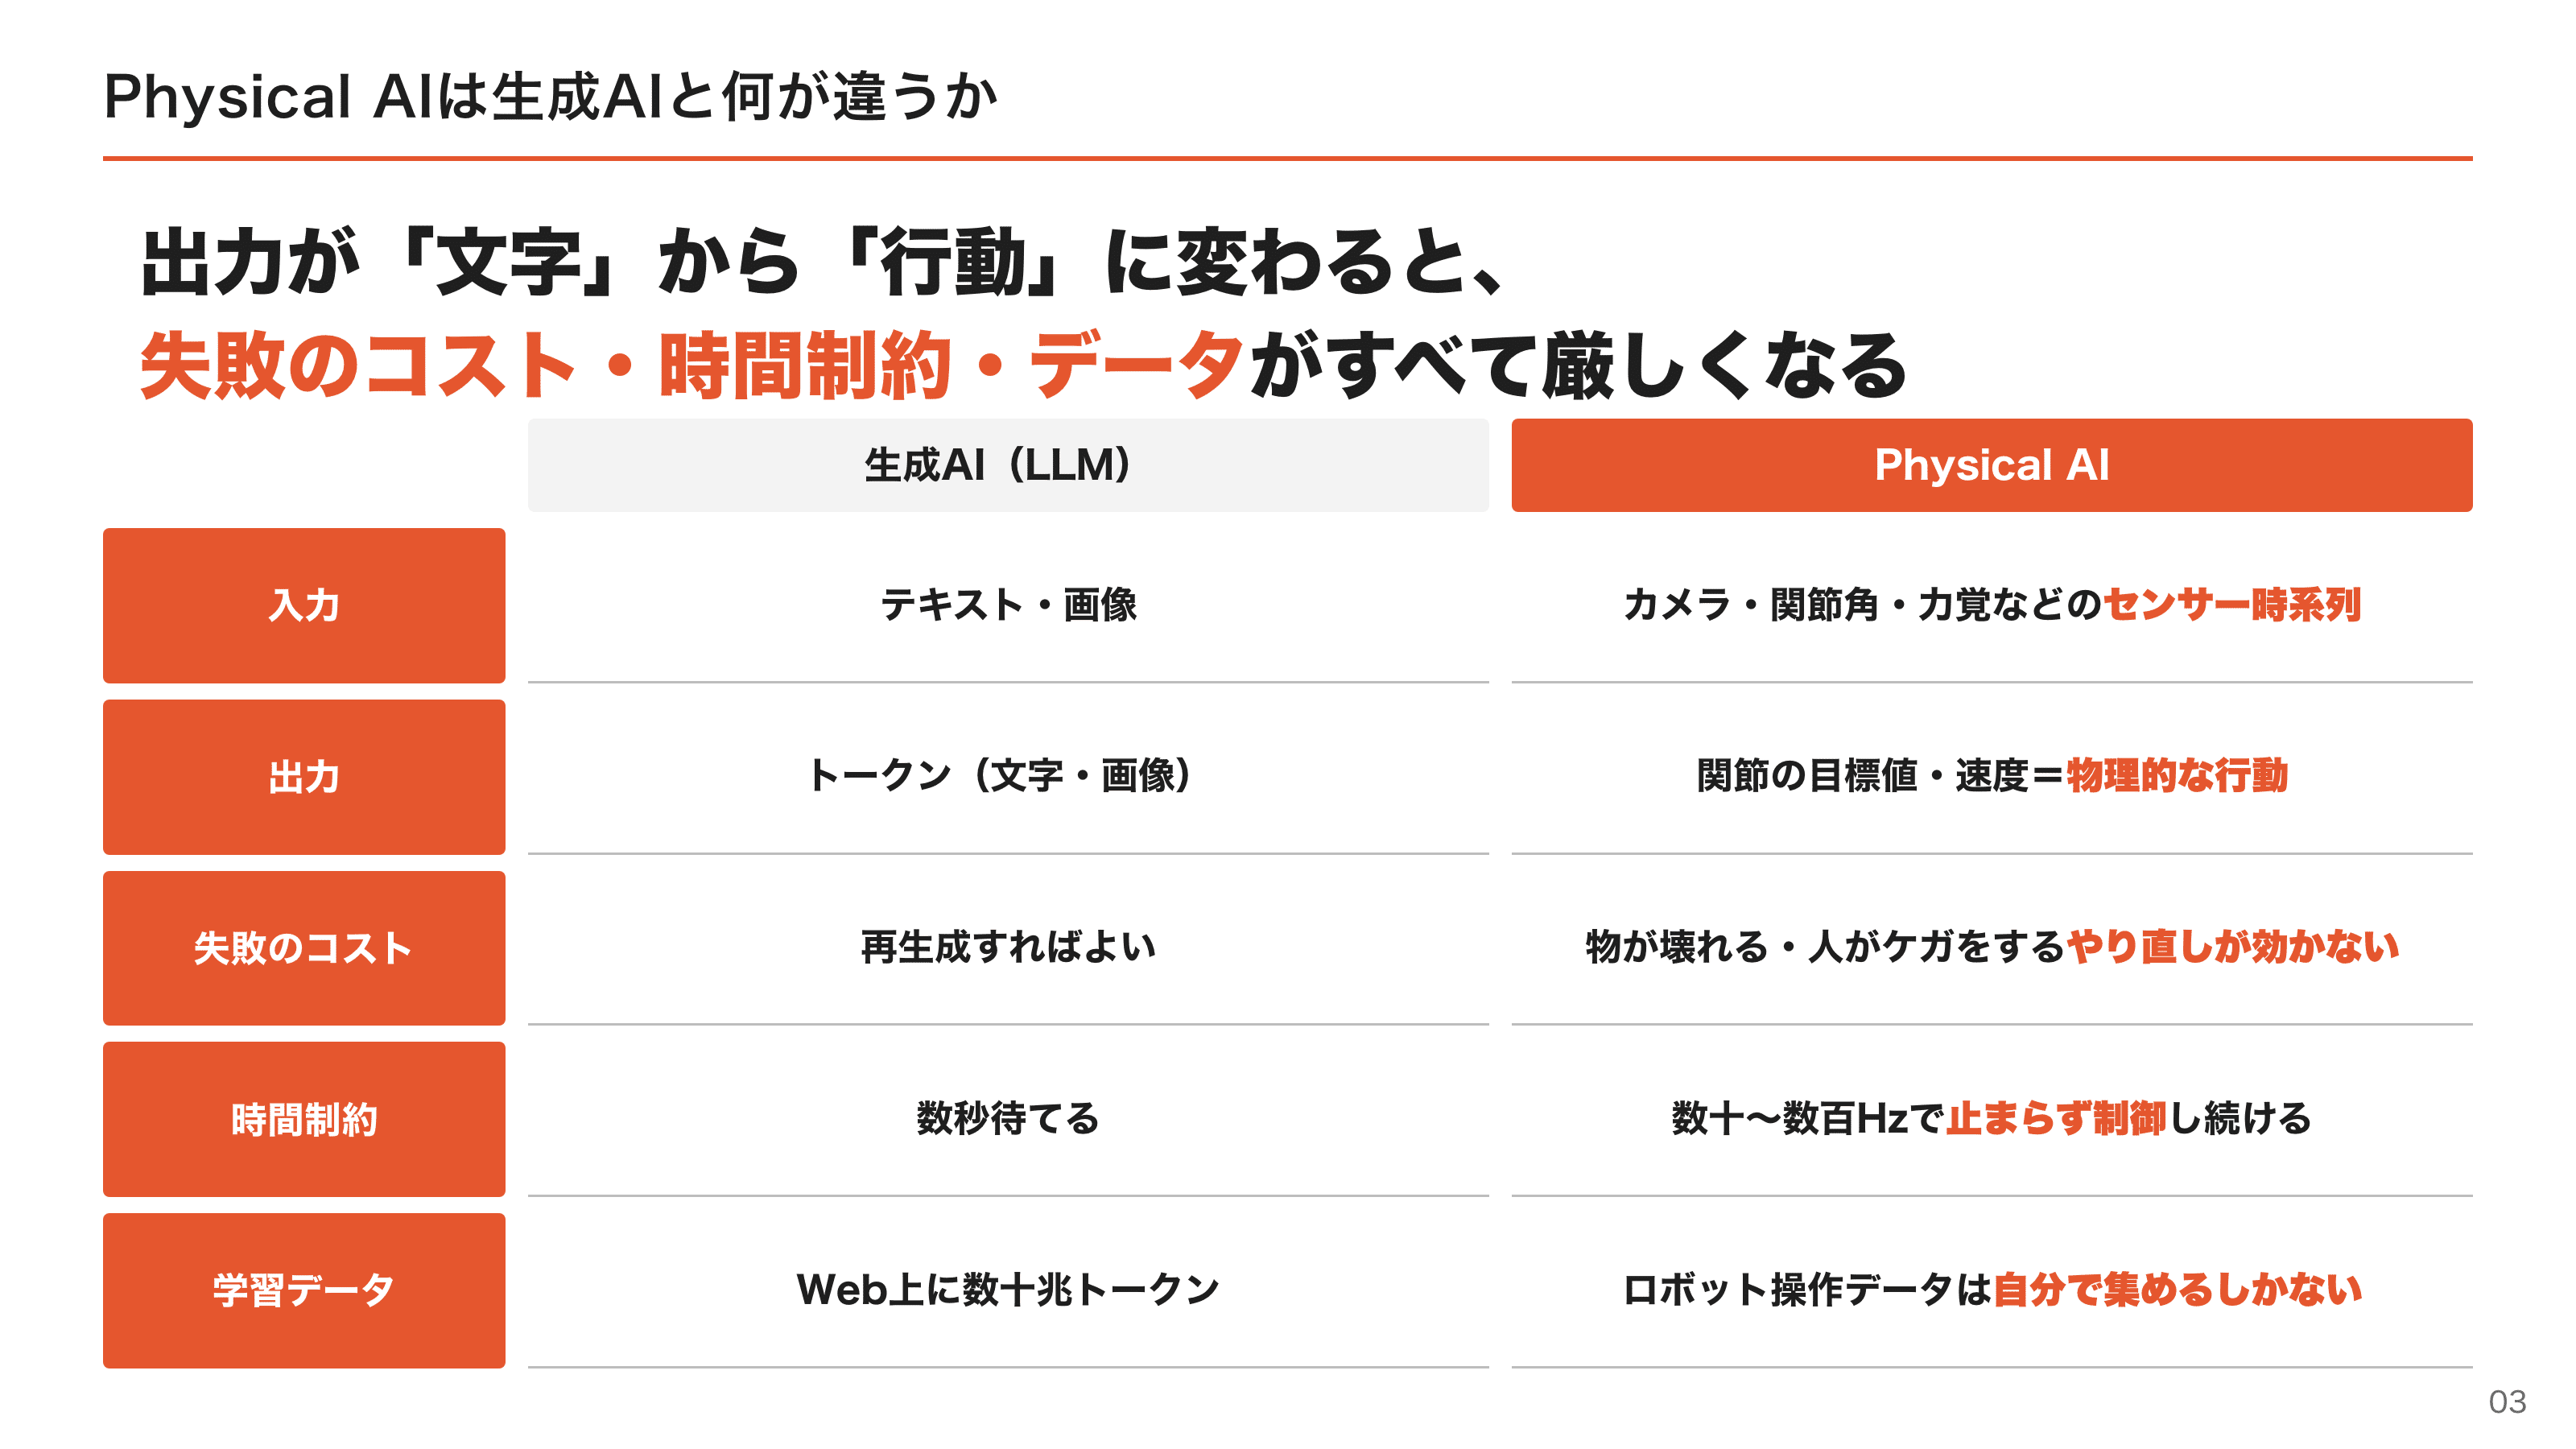
失敗のコストが大きい:LLMの誤答は再生成すれば済みますが、ロボットの誤動作は物を壊し、人を傷つけるため、「やり直し」を前提にした開発ができません。
時間制約が厳しい:チャットの応答は数秒待てますが、ロボットは数十〜数百Hz(1秒に数十〜数百回)で制御値を出し続ける必要があります。巨大なモデルをそのまま使うと間に合いません。
データがない:LLMはWeb上の膨大なテキストで学習できましたが、「この関節をこの角度で動かしたら、コップがこう持ち上がった」というなデータはWeb上にほとんど存在しないため、自分たちで集めるしかありません。
この3点、特にデータ不足が、Physical AIの技術とビジネスのほぼすべてを規定しています。以降の章の大半は、この問題への各社の答えです。
従来のロボットとの違い
工場では何十年も前からロボットが働いています。従来の産業用ロボットとの違いは、動きを誰が決めるかです。
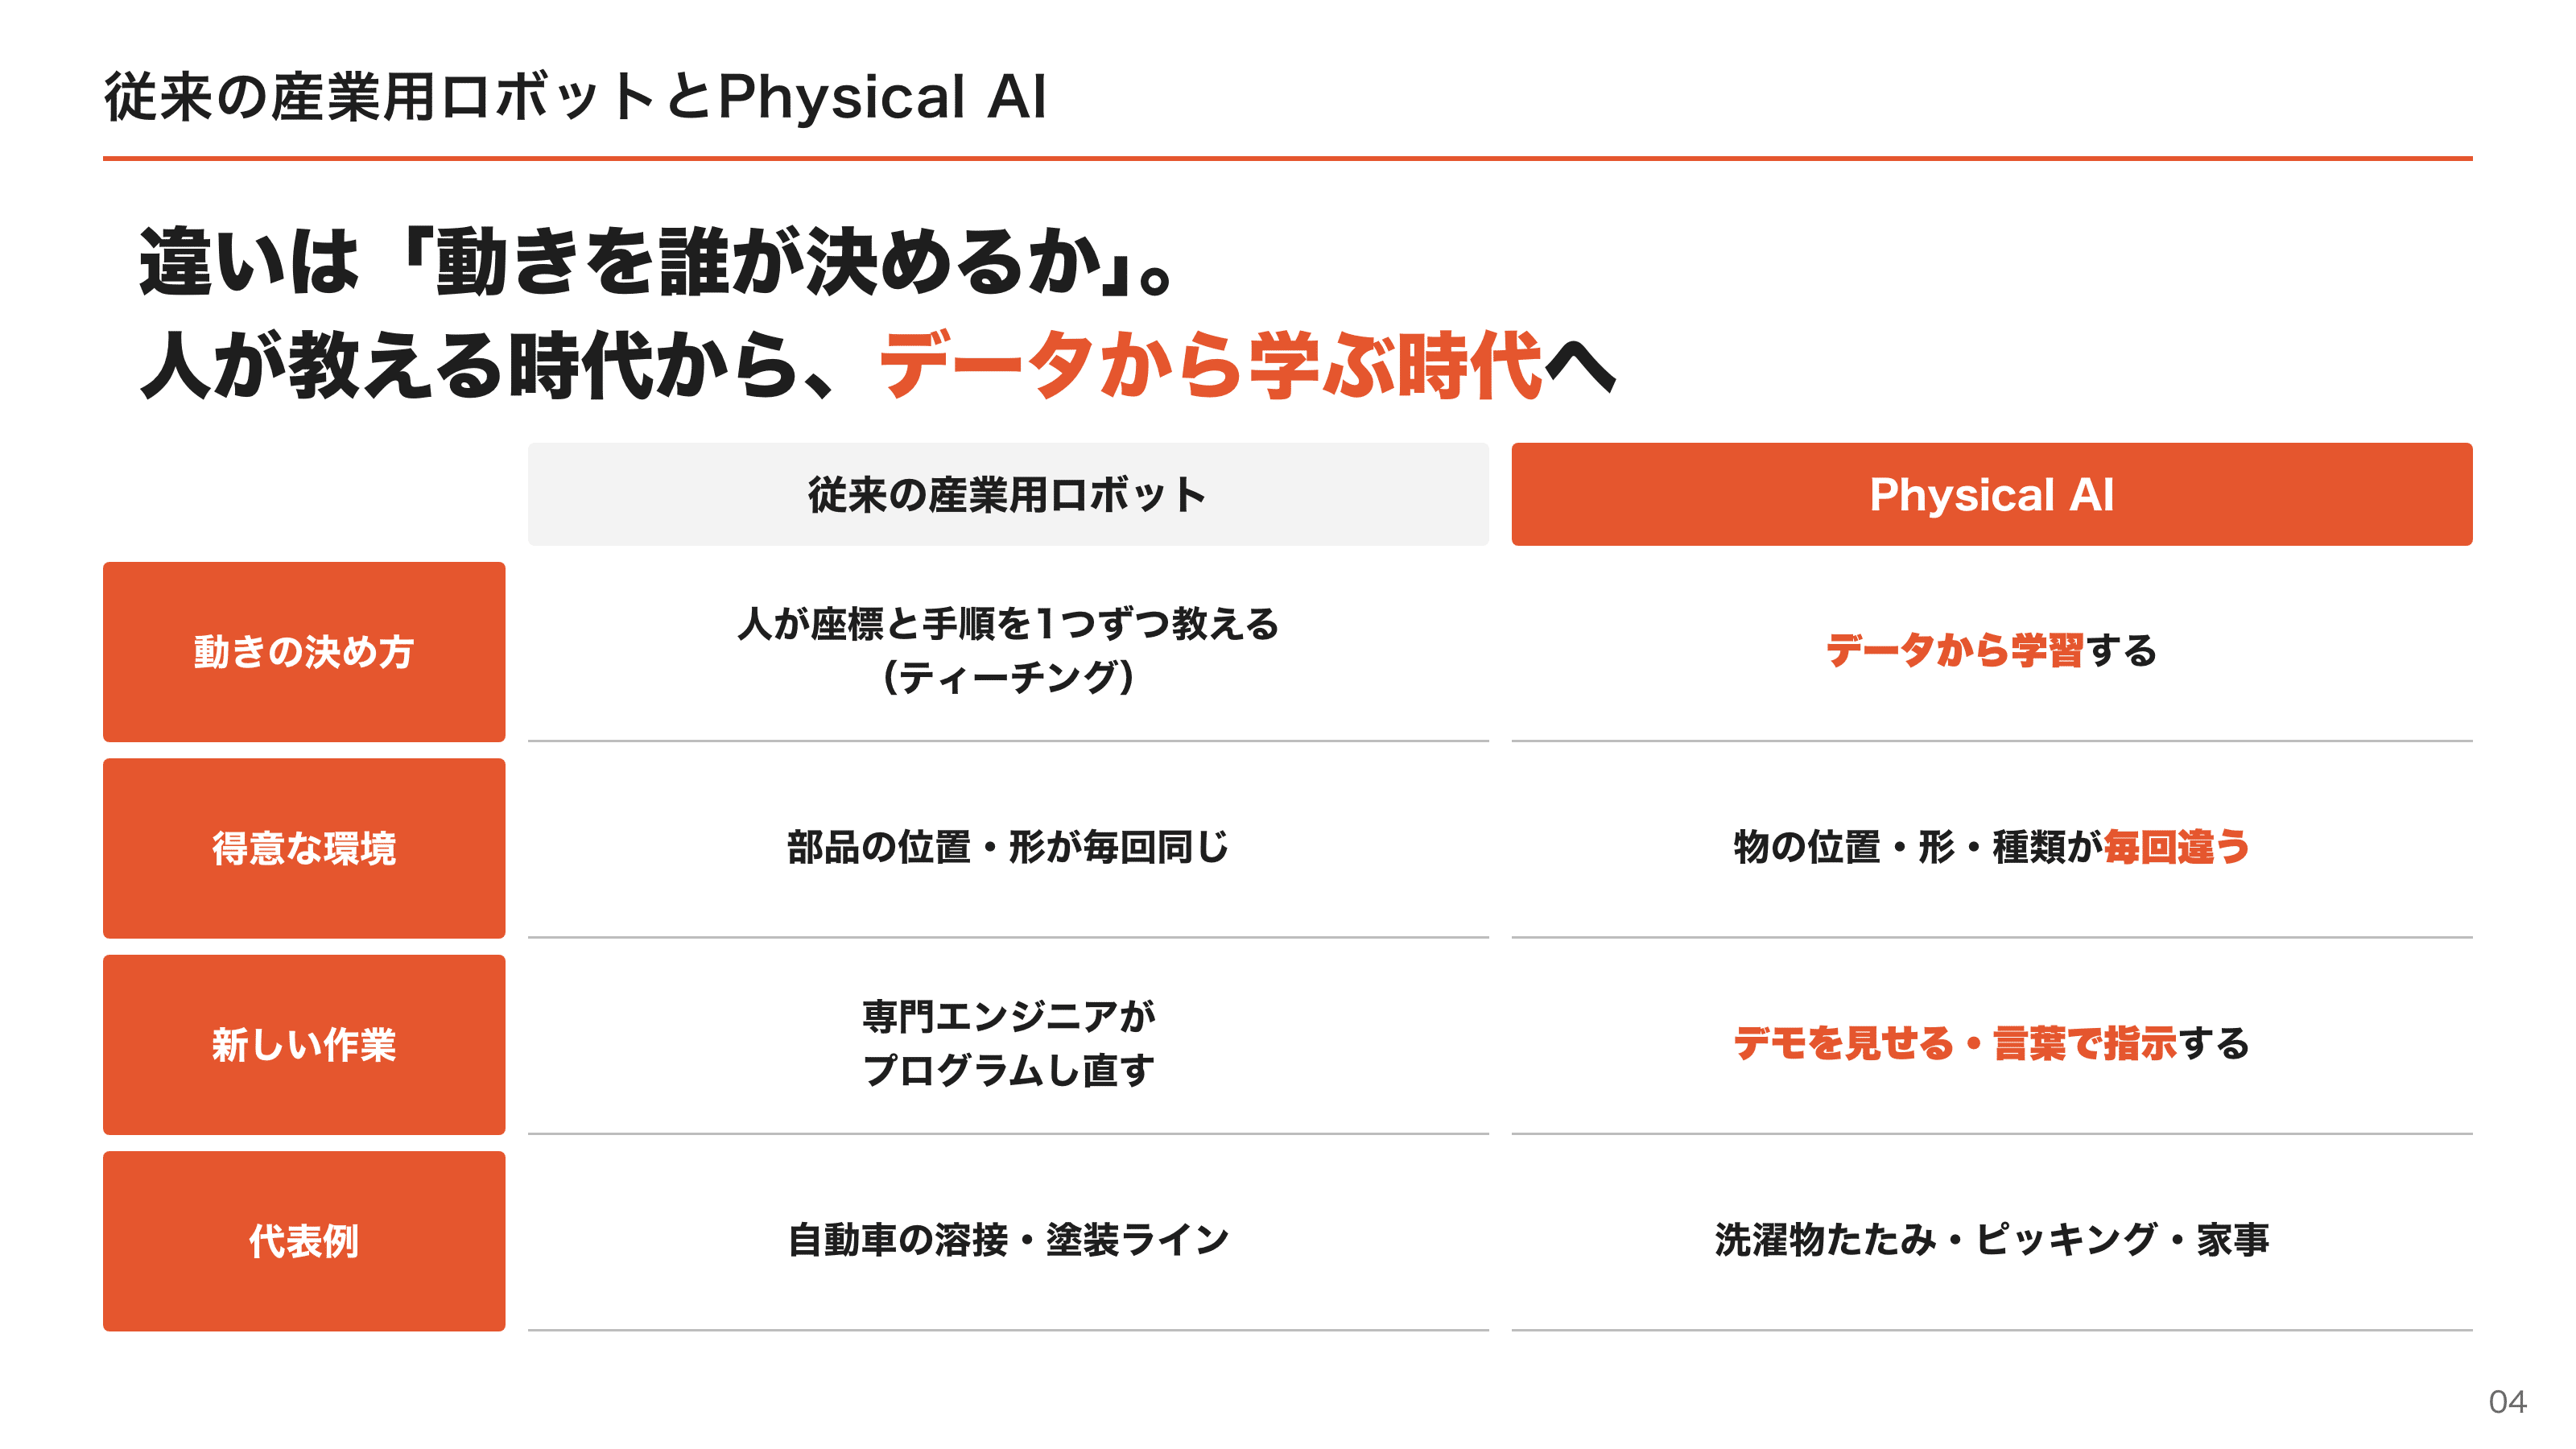
従来型は「決まった動きを、ミリ単位で、何万回でも正確に繰り返す」ことに最適化されています。逆に、置き場所が毎回少しずれる、柔らかい、形が変わる、といった対象は苦手でした。物流倉庫のピッキングや家事が自動化されてこなかったのはこのためです。
人間に簡単なことほどロボットには難しい
ロボット研究にはモラベックのパラドックスという有名な経験則があります。チェスや計算のように人間が難しいと感じることはコンピュータには簡単で、歩く、物をつかむといった幼児でもできることのほうがコンピュータには難しい、というものです。
LLMは「人間には難しい知的作業」を一気に崩しました。Physical AIが挑んでいるのは、その逆側にある「人間には簡単な身体的作業」です。人間は何億年もの進化と、生まれてから毎日続く身体経験でこれを獲得しています。ロボットにはその蓄積がありません。
Physical AIの価値は「人手不足の現場で、毎回少しずつ違う作業」を自動化できる点にあります。製造・物流・介護・建設など、これまで自動化できなかった領域の多くがこれに該当します。
2. なぜ今なのか:4つの追い風
ロボットに学習で動きを覚えさせる研究自体は2010年代からありました。それが2023年以降に一気に加速したのは、4つの条件が同時にそろったからです。
① 基盤モデルという「常識」が手に入った
最大の変化は、画像と言語を理解するモデル:VLM(Vision-Language Model)が、ロボットの頭脳として転用できるとわかったことです。
以前のロボット学習では、「赤いコップ」が何かを知らない状態からすべて学ばせる必要がありました。現在は、Webの画像とテキストで事前学習したVLMを出発点にできます。VLMはすでに「コップとは何か」「赤とは何か」「たたむとはどういうことか」とういうようなことを知っています。ロボットはそこに体の動かし方だけを追加で学べばよくなりました。
GoogleのRT-2(2023年)は、VLMをロボットデータで追加学習すると、ロボットデータに一度も出てこない物体や指示(「絶滅した動物を拾って」と言われて恐竜のおもちゃを拾う、など)にも対応できることを示しました。これが現在のVLAブームの起点です。
② 「ロボットのImageNet」ができ始めた
データ不足に対して、研究コミュニティは共同でデータを集め始めました。
Open X-Embodiment(2023年10月)
Google DeepMindを中心に21機関(研究室単位では34)が持ち寄った既存の60データセットを、共通の形式に統合した公開データセットです。単腕アームから双腕ロボット、四足ロボットまで22種類のロボットによる100万件超の動作データを含み、スキルは527種類にのぼります。研究チームはこのデータでモデルを学習させ、次の結果を報告しました。
データの少ない環境では、統合データで学習したRT-1-Xが、各データセット専用に学習したモデルより約50%高い成功率を出した
RT-2-Xは、自分のロボットではなく他のロボットのデータにしか含まれないスキルの評価で、RT-2の約3倍の成績を出した
DROID(2024年3月)
場北米・アジア・欧州の13機関で50人のデータ収集者が、12か月かけて家庭・オフィス・研究室など564の場面を回り、86種類の作業で約7.6万回(約350時間)のデモを集めました。
全拠点で機材をそろえた:Franka Panda(7自由度アーム)、位置を変えられる外部ステレオカメラ2台と手首カメラ1台、VRコントローラ(Oculus Quest 2)による遠隔操作
成功したエピソードの95%に、言い回しの異なる指示文が3通りずつ付いている
DROIDを混ぜて学習した方策は、Open X-Embodimentを混ぜた場合などと比べ、成功率が学習時と同じ環境で平均22ポイント、初めての環境で17ポイント上がった
LLMにおけるWebテキストほどの量はまだありませんが、「データを混ぜれば汎用性が上がる」というスケーリングの兆しが見えたことが投資を呼び込みました。
③ シミュレーションとGPUが安くなった
GPU上で動く物理シミュレーターが進化し、数千体のロボットを並列に、実時間よりはるかに速く動かして学習できるようになりました。四足歩行ロボットや人型ロボットの歩行の多くは、今ではシミュレーション内の強化学習で獲得され、そのまま実機に移されています。
④ ハードウェアが安くなった
ロボット本体の価格が急速に下がりました。かつて研究用の人型ロボットは数千万円しましたが、中国のUnitreeは人型ロボットG1を米国の公式ストアで1万3,500ドル〜(税・関税別)で販売しています。2026年8月には上海の科創板に上場し、初日の終値は公開価格の約5.6倍になりました。研究用のロボットアームも、3Dプリンタと市販のサーボモーターで組める数万円のオープンソース設計(SO-101など、6章で紹介)が普及しました。
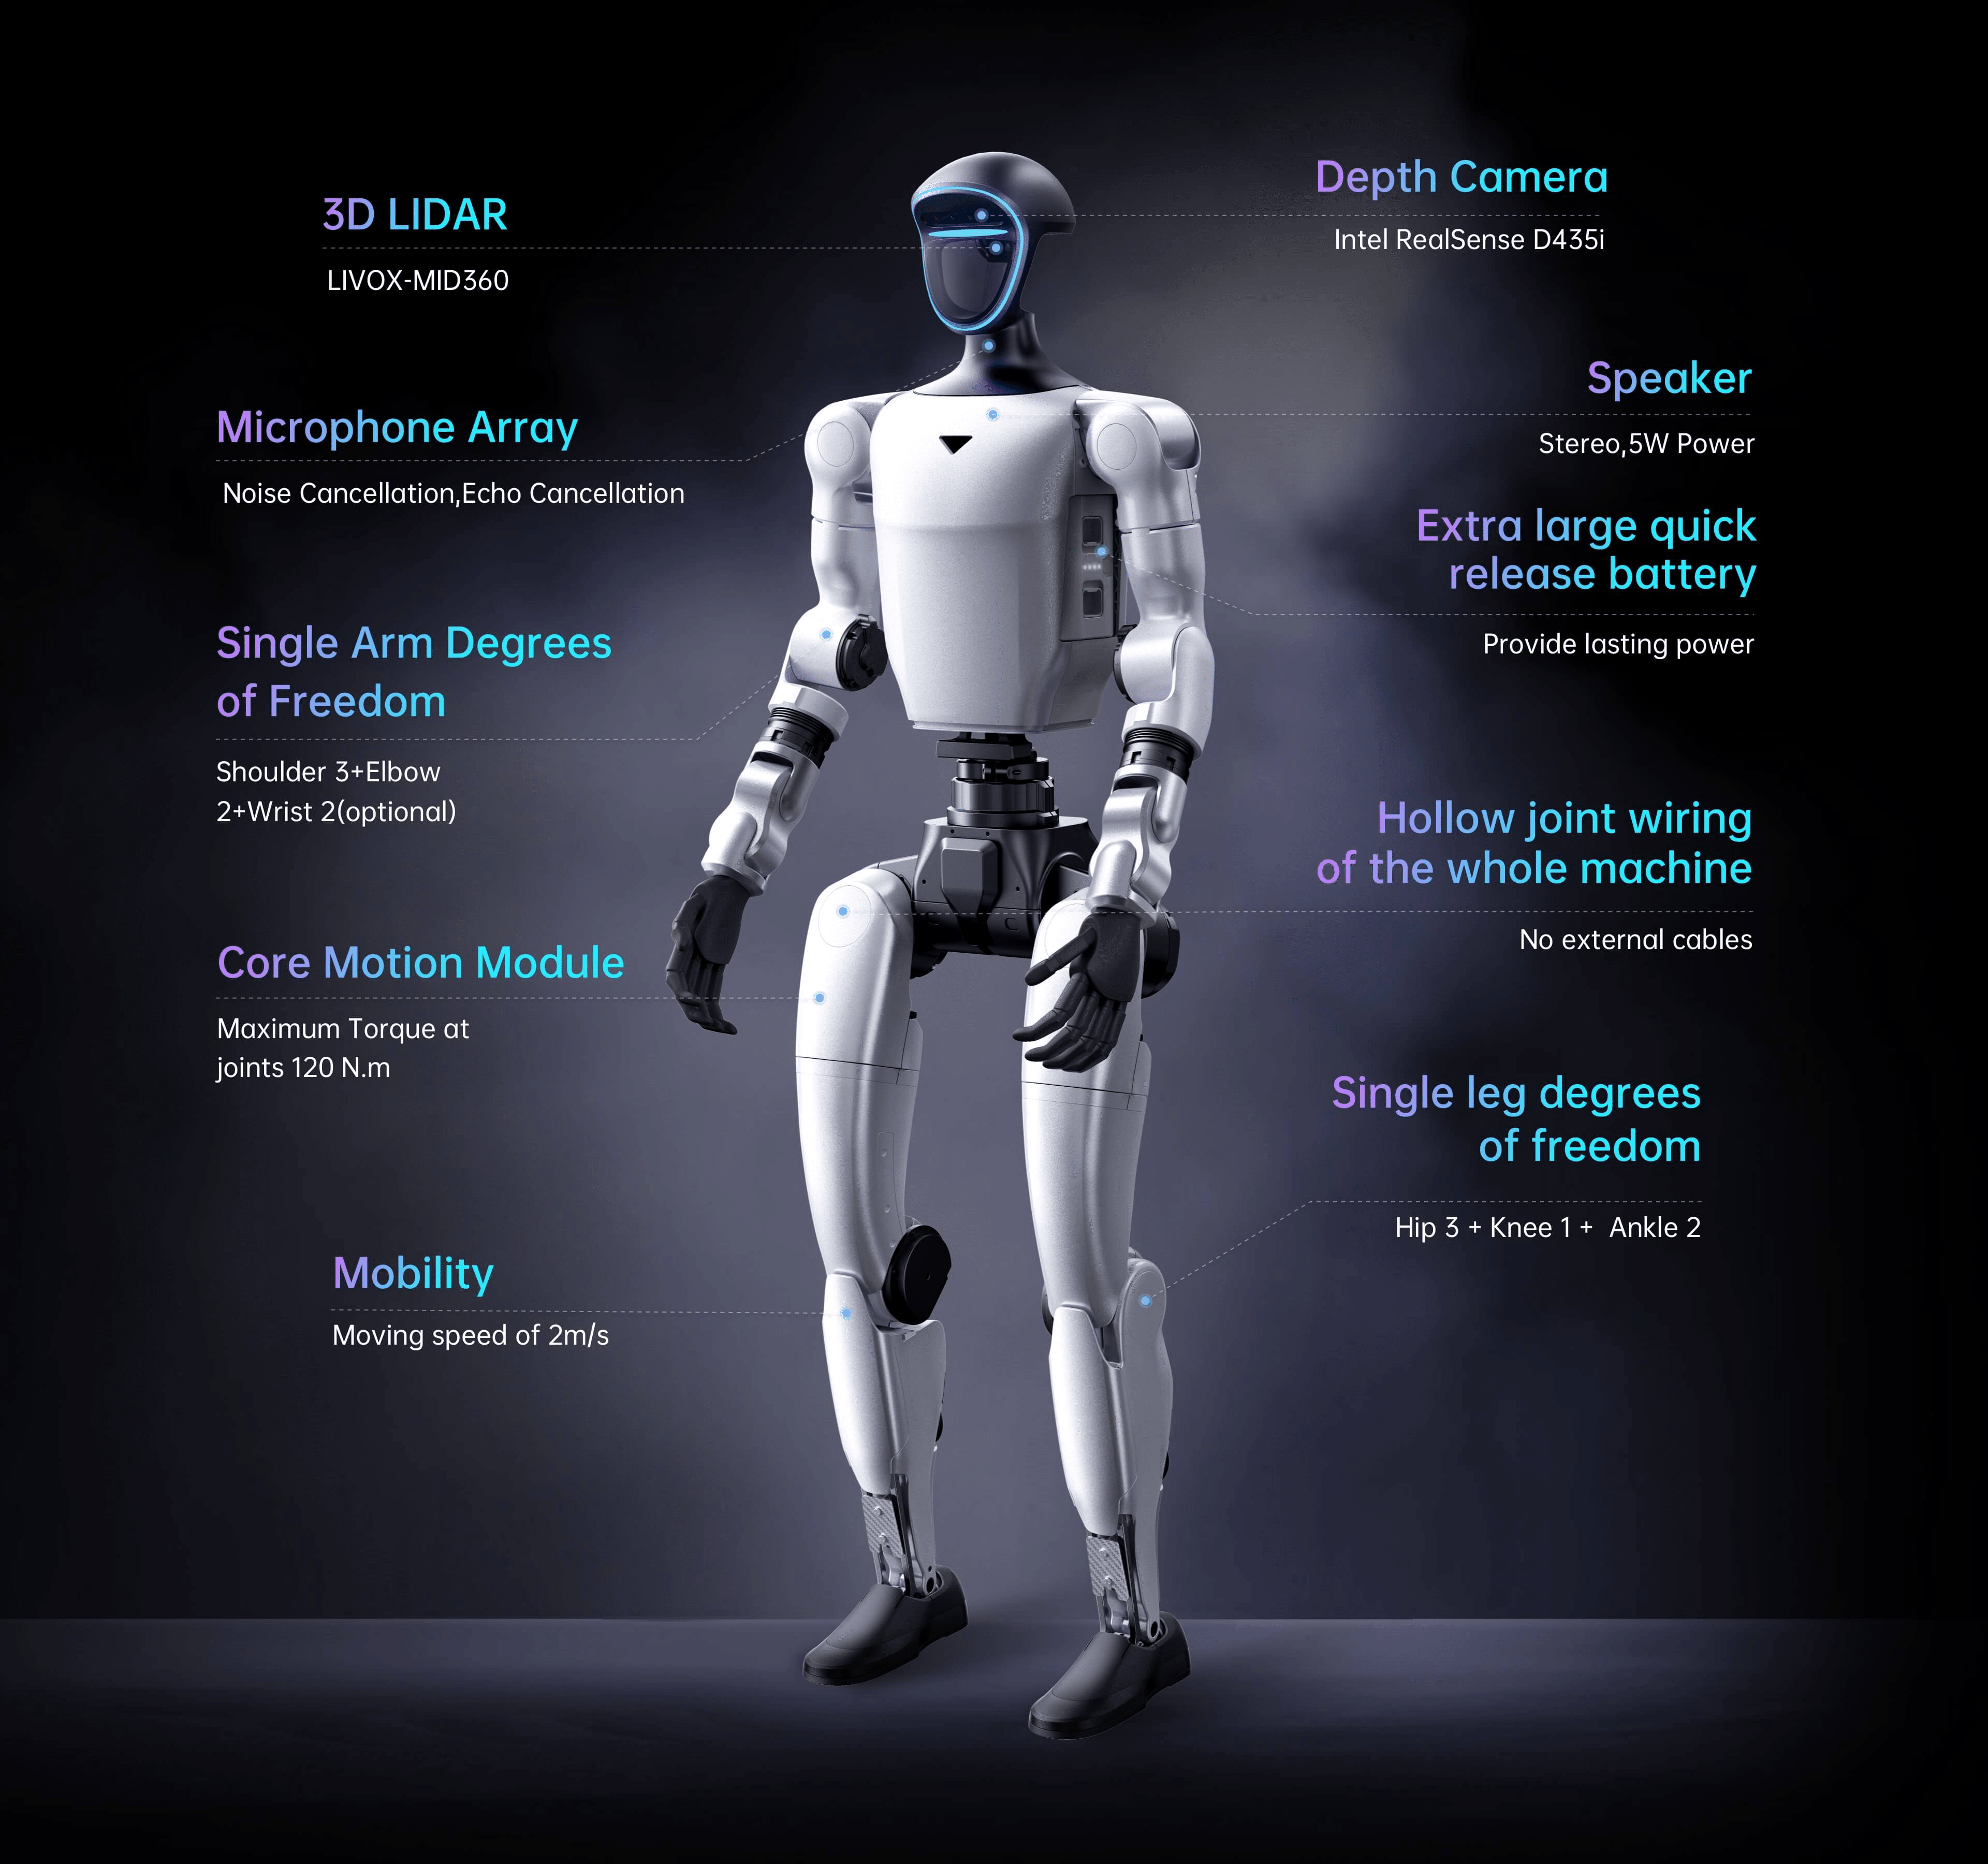
https://www.unitree.com/g1
3. 技術の地図
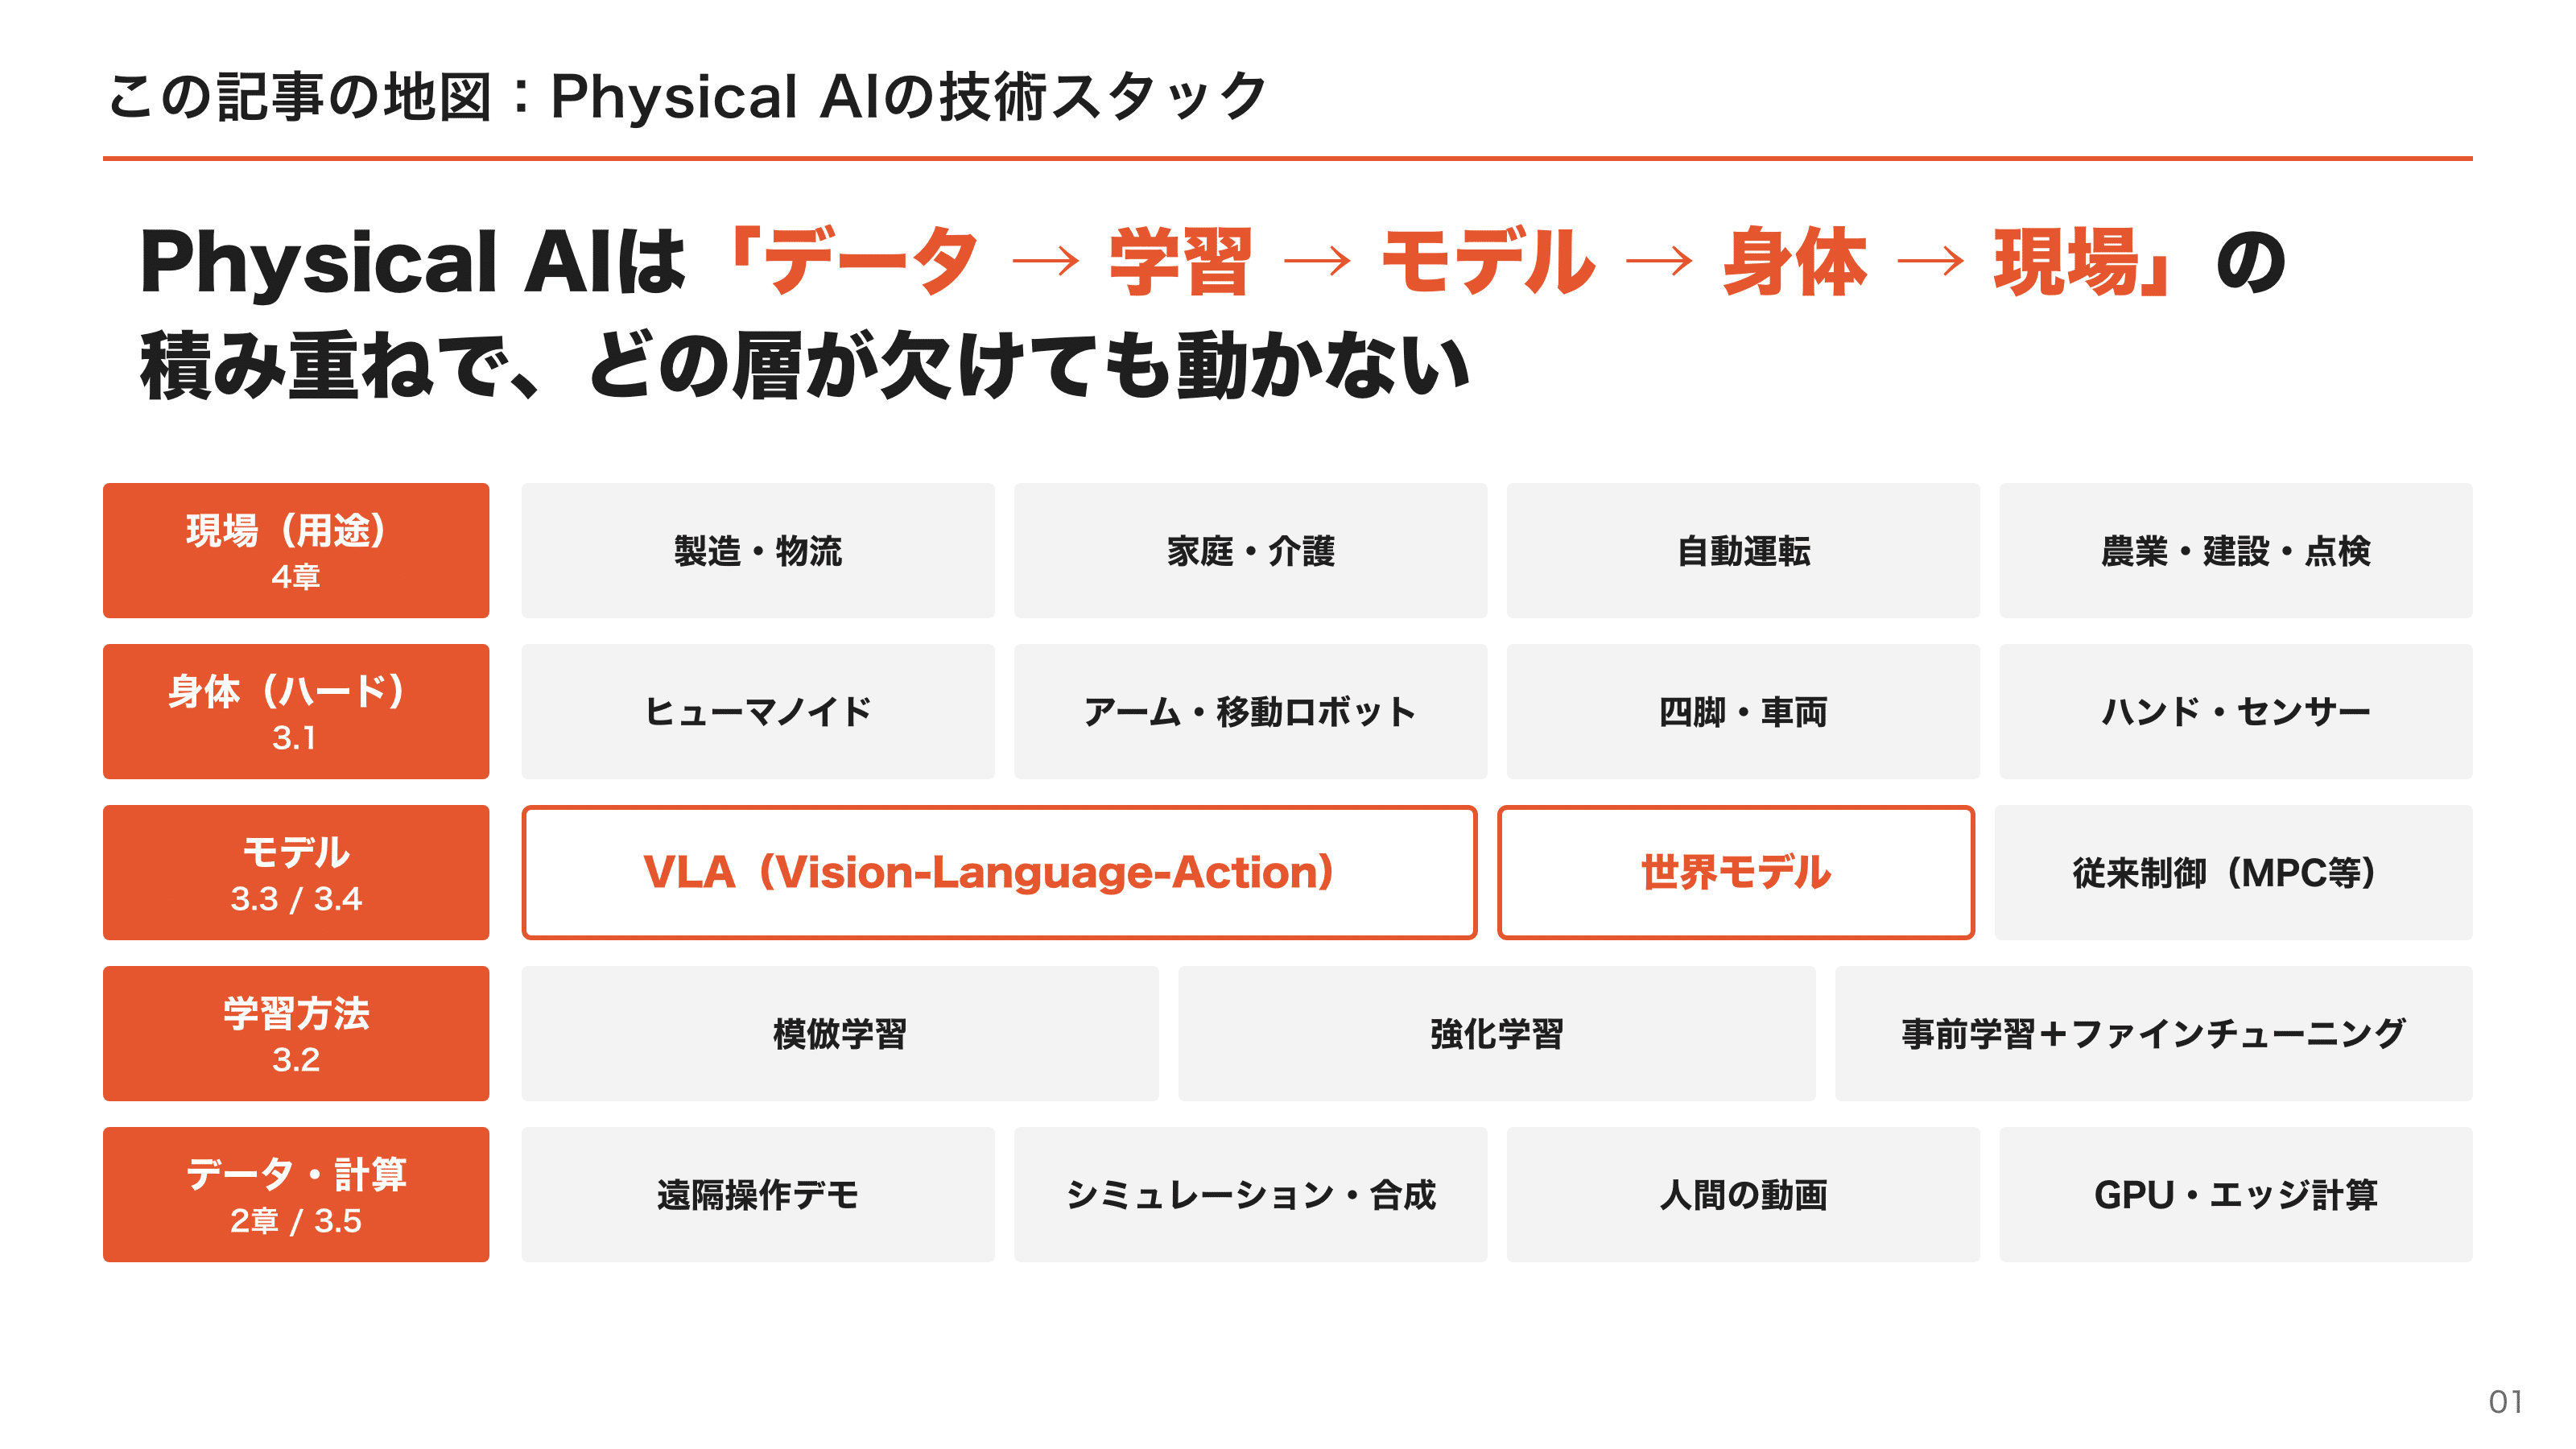
次に、Physical AIを構成する技術を、身体 → 学習方法 → モデル → データの順に見ていきます。
3.1 構成要素:身体を知る
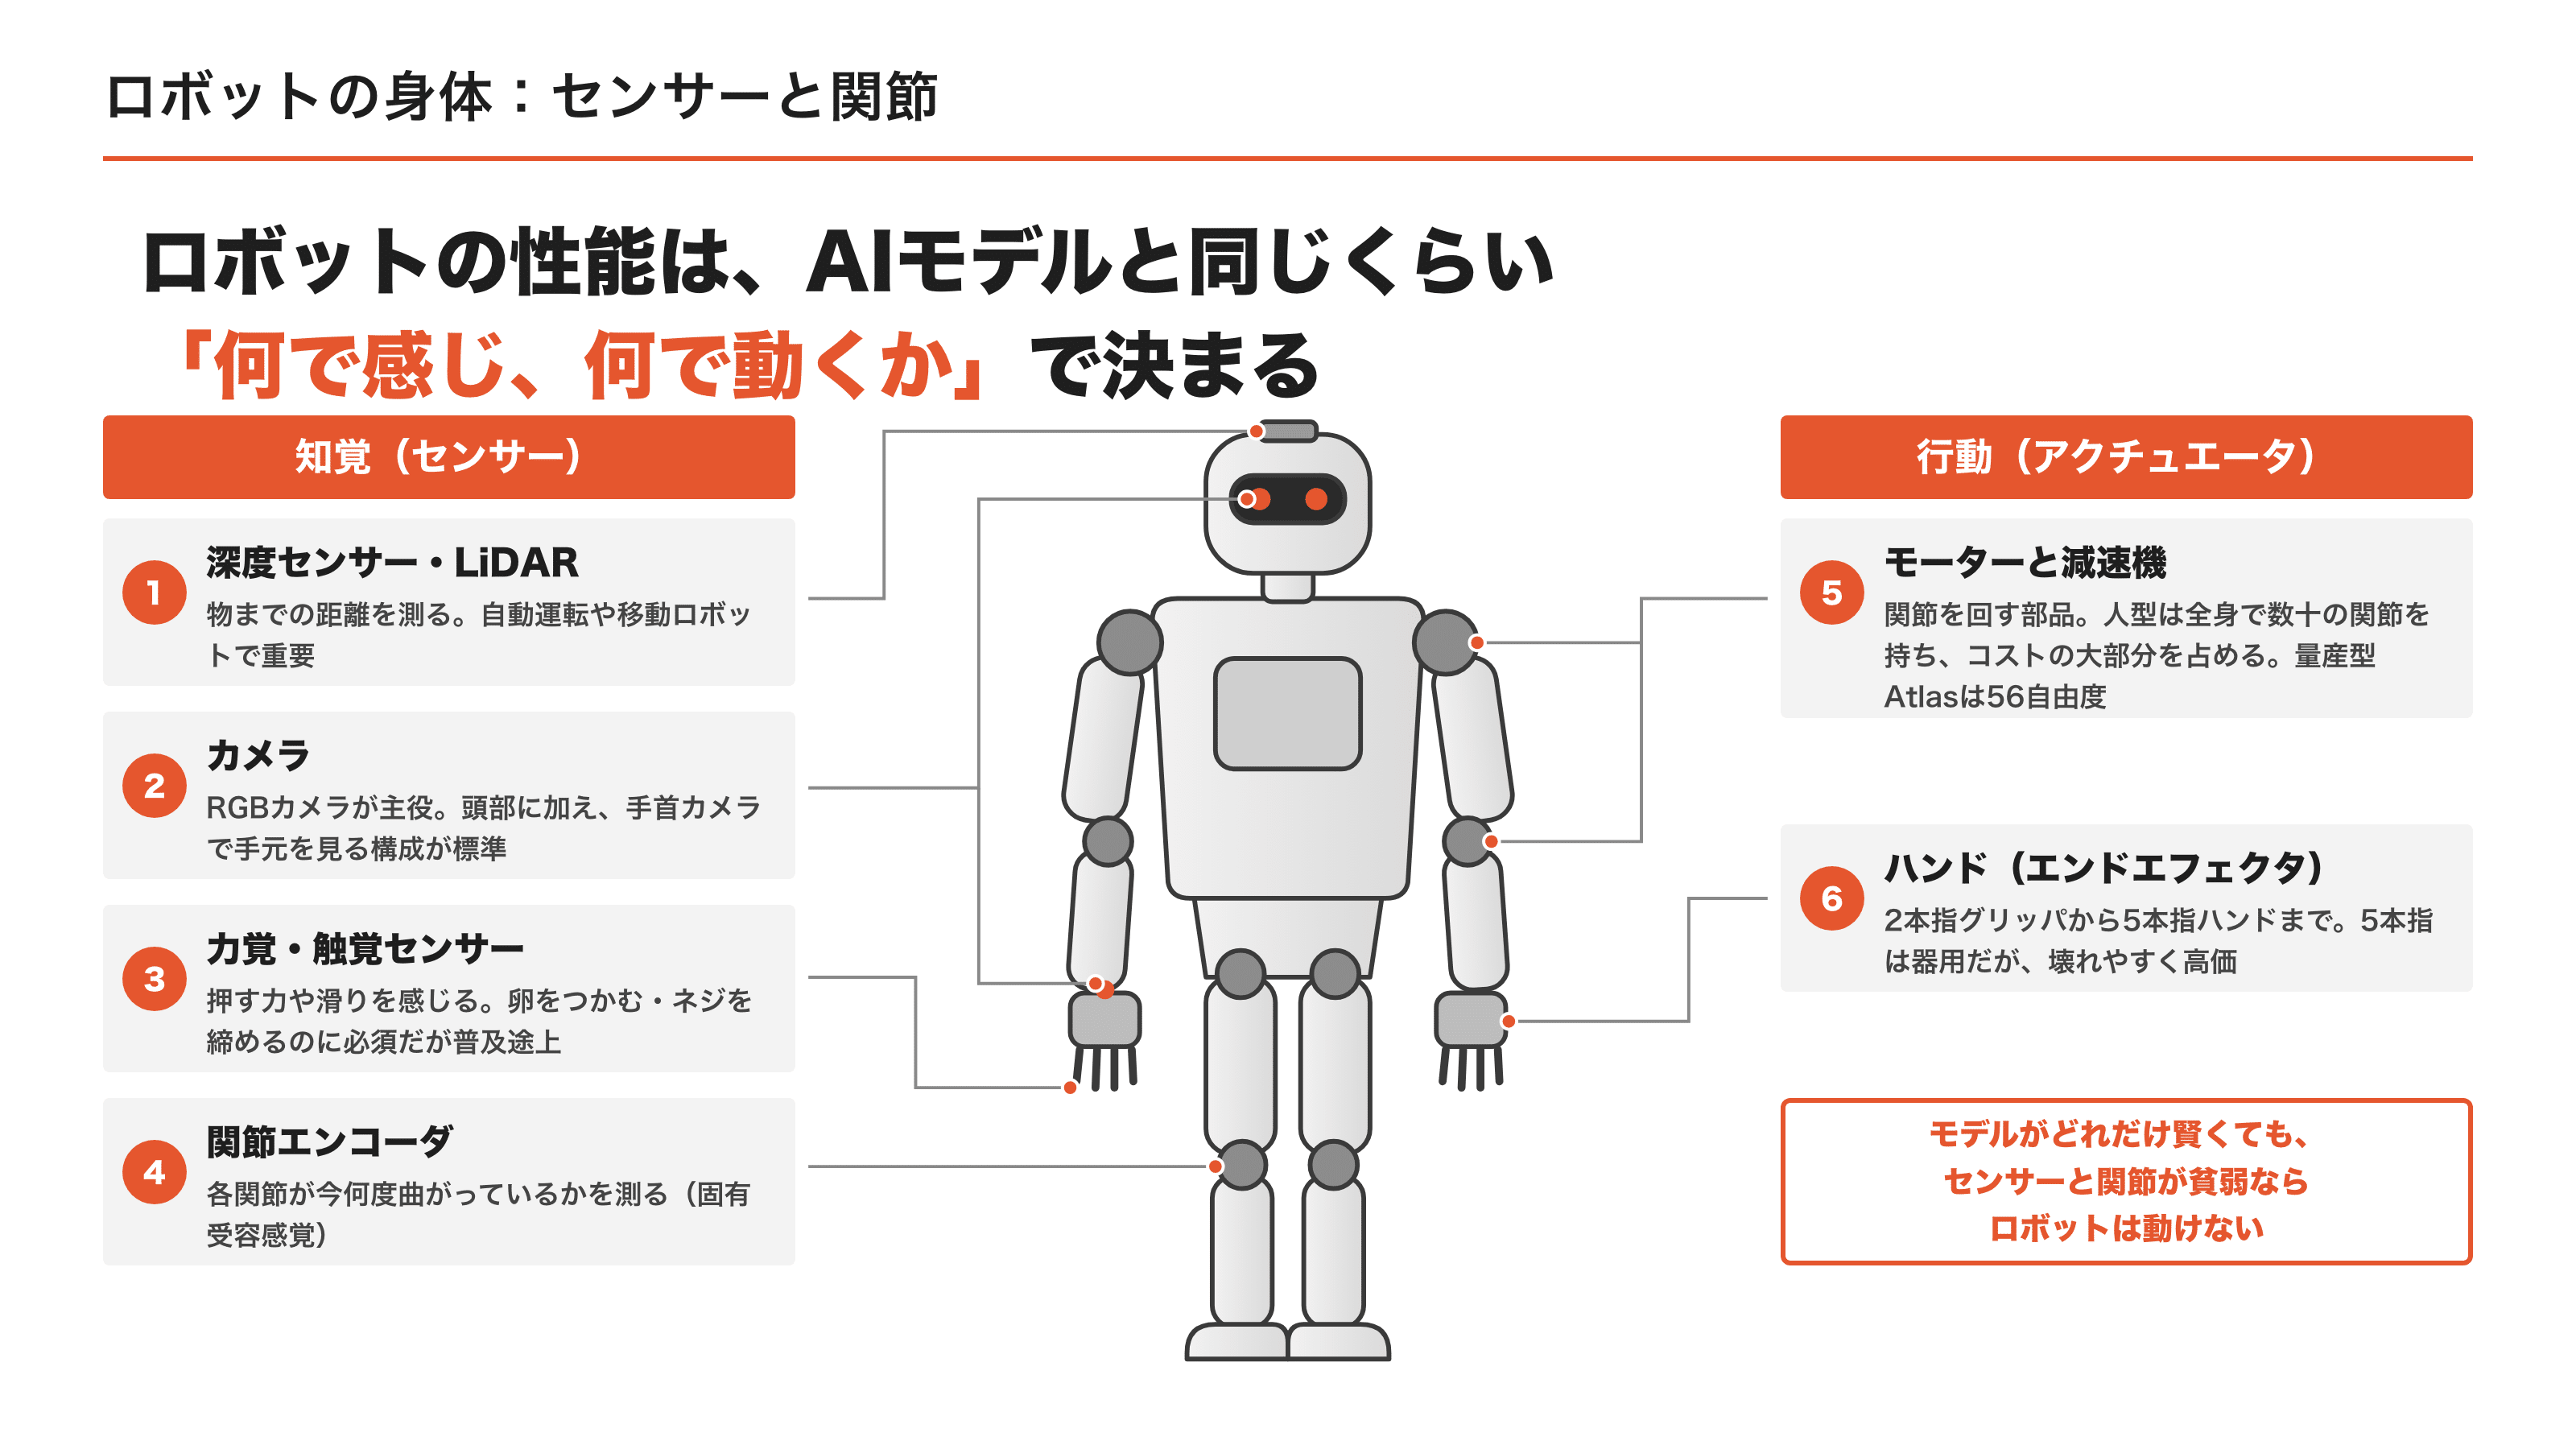
知覚(センサー)
カメラ:RGBカメラが主役です。頭部に加え、手首にカメラを付けて手元を見る構成が標準になりました。
深度センサー・LiDAR:物までの距離を測ります。自動運転や移動ロボットで重要です。
力覚・触覚センサー:どれくらいの力で押しているか、滑っていないかを感じ取ります。卵をつかむ、ネジを締めるといった作業に必須ですが、カメラに比べて普及が遅れています。
関節エンコーダ:各関節が今何度曲がっているかを測ります(固有受容感覚)。
行動(アクチュエータ)
モーターと減速機:関節を回す部品です。人型ロボットは全身で数十の関節を持ち(量産型Atlasは56自由度)、モーターと減速機がコストの大部分を占めます。
ハンド(エンドエフェクタ):2本指のグリッパから、人の手に近い5本指ハンドまであります。5本指は器用ですが、壊れやすく高価です。
形態(エンボディメント)
ロボットの「体の形」をエンボディメントと呼びます。アーム、車輪付きの移動マニピュレータ、四足、人型、そして自動車もPhysical AIの一形態です。同じAIモデルでも、体が違えば出すべき行動(関節の数、可動範囲)が違います。1つのモデルで複数の体を動かせるか(cross-embodiment)は、現在の研究の大きなテーマです。
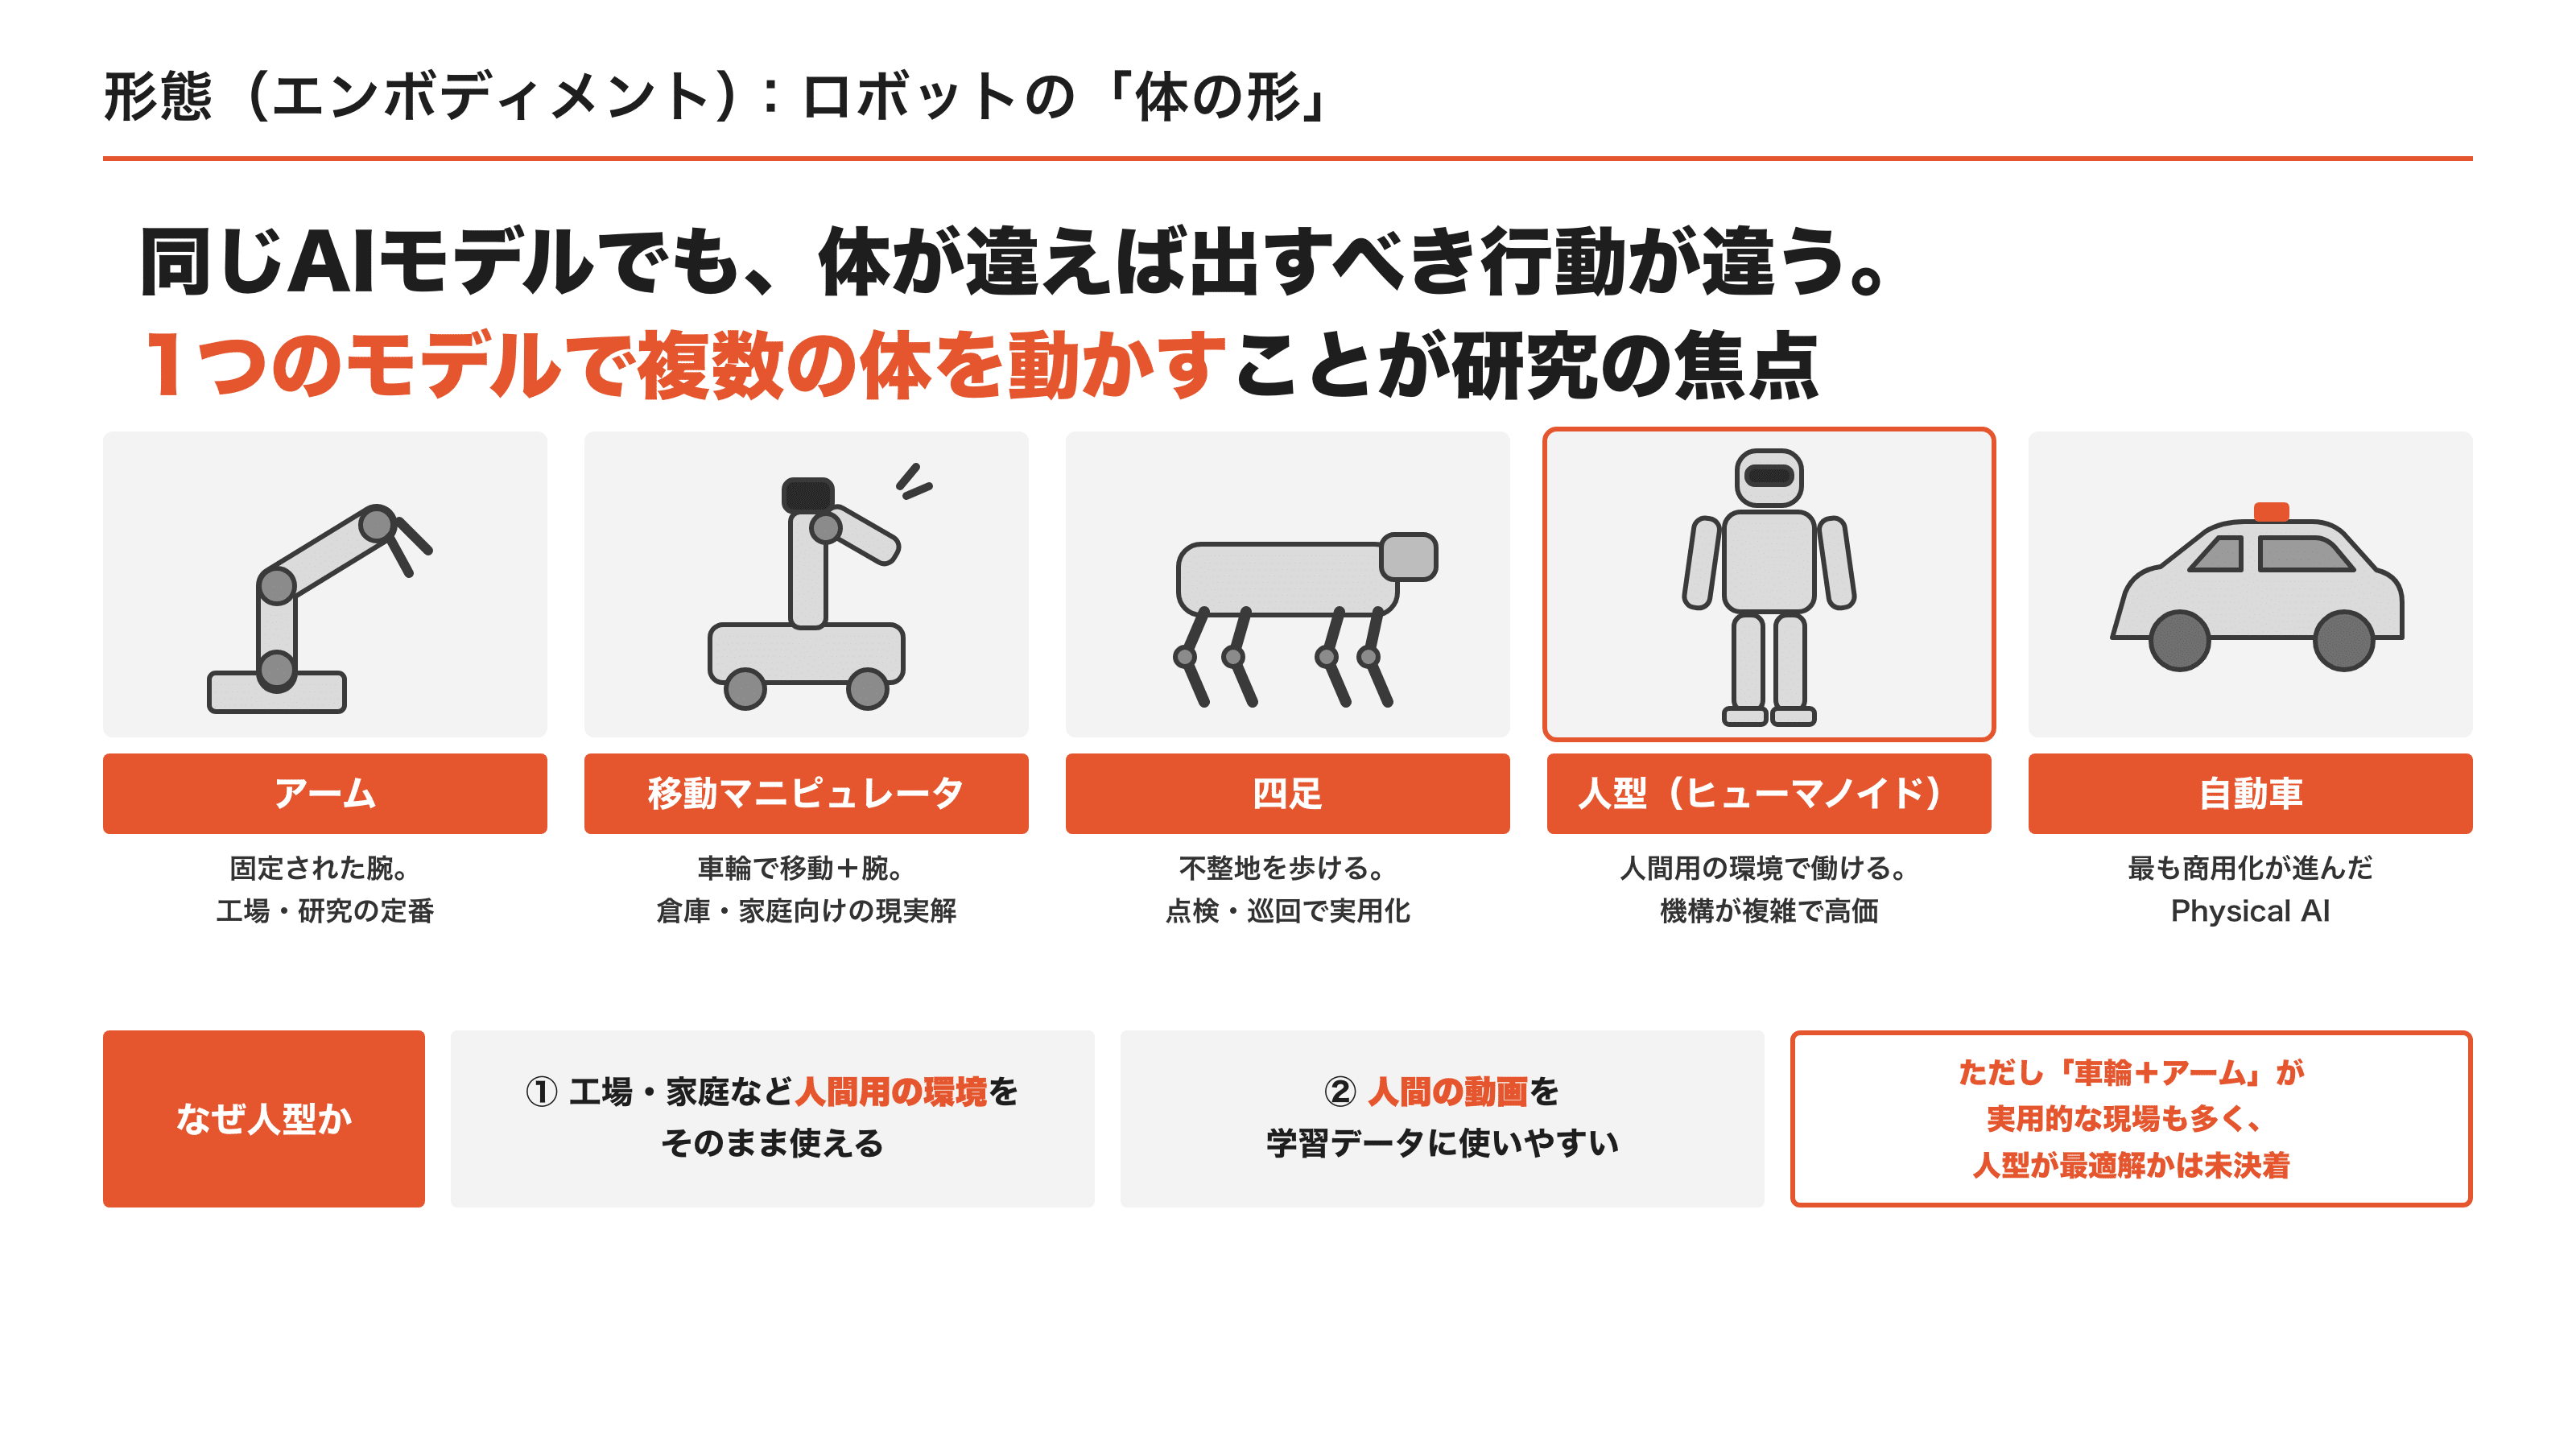
なぜ人型なのか:人型は機構が複雑で高価です。それでも各社が人型に賭けるのは、
①工場・家庭など人間用に作られた環境をそのまま使える
②人間の動画を学習データとして使いやすい
という2つの理由からです。
(ただし、車輪+アームの方が実用的な現場も多く、人型が最適解かどうかはまだ決着していません)
3.2 学習方法:模倣学習と強化学習
ロボットに動きを学ばせる方法は大きく2つあります。
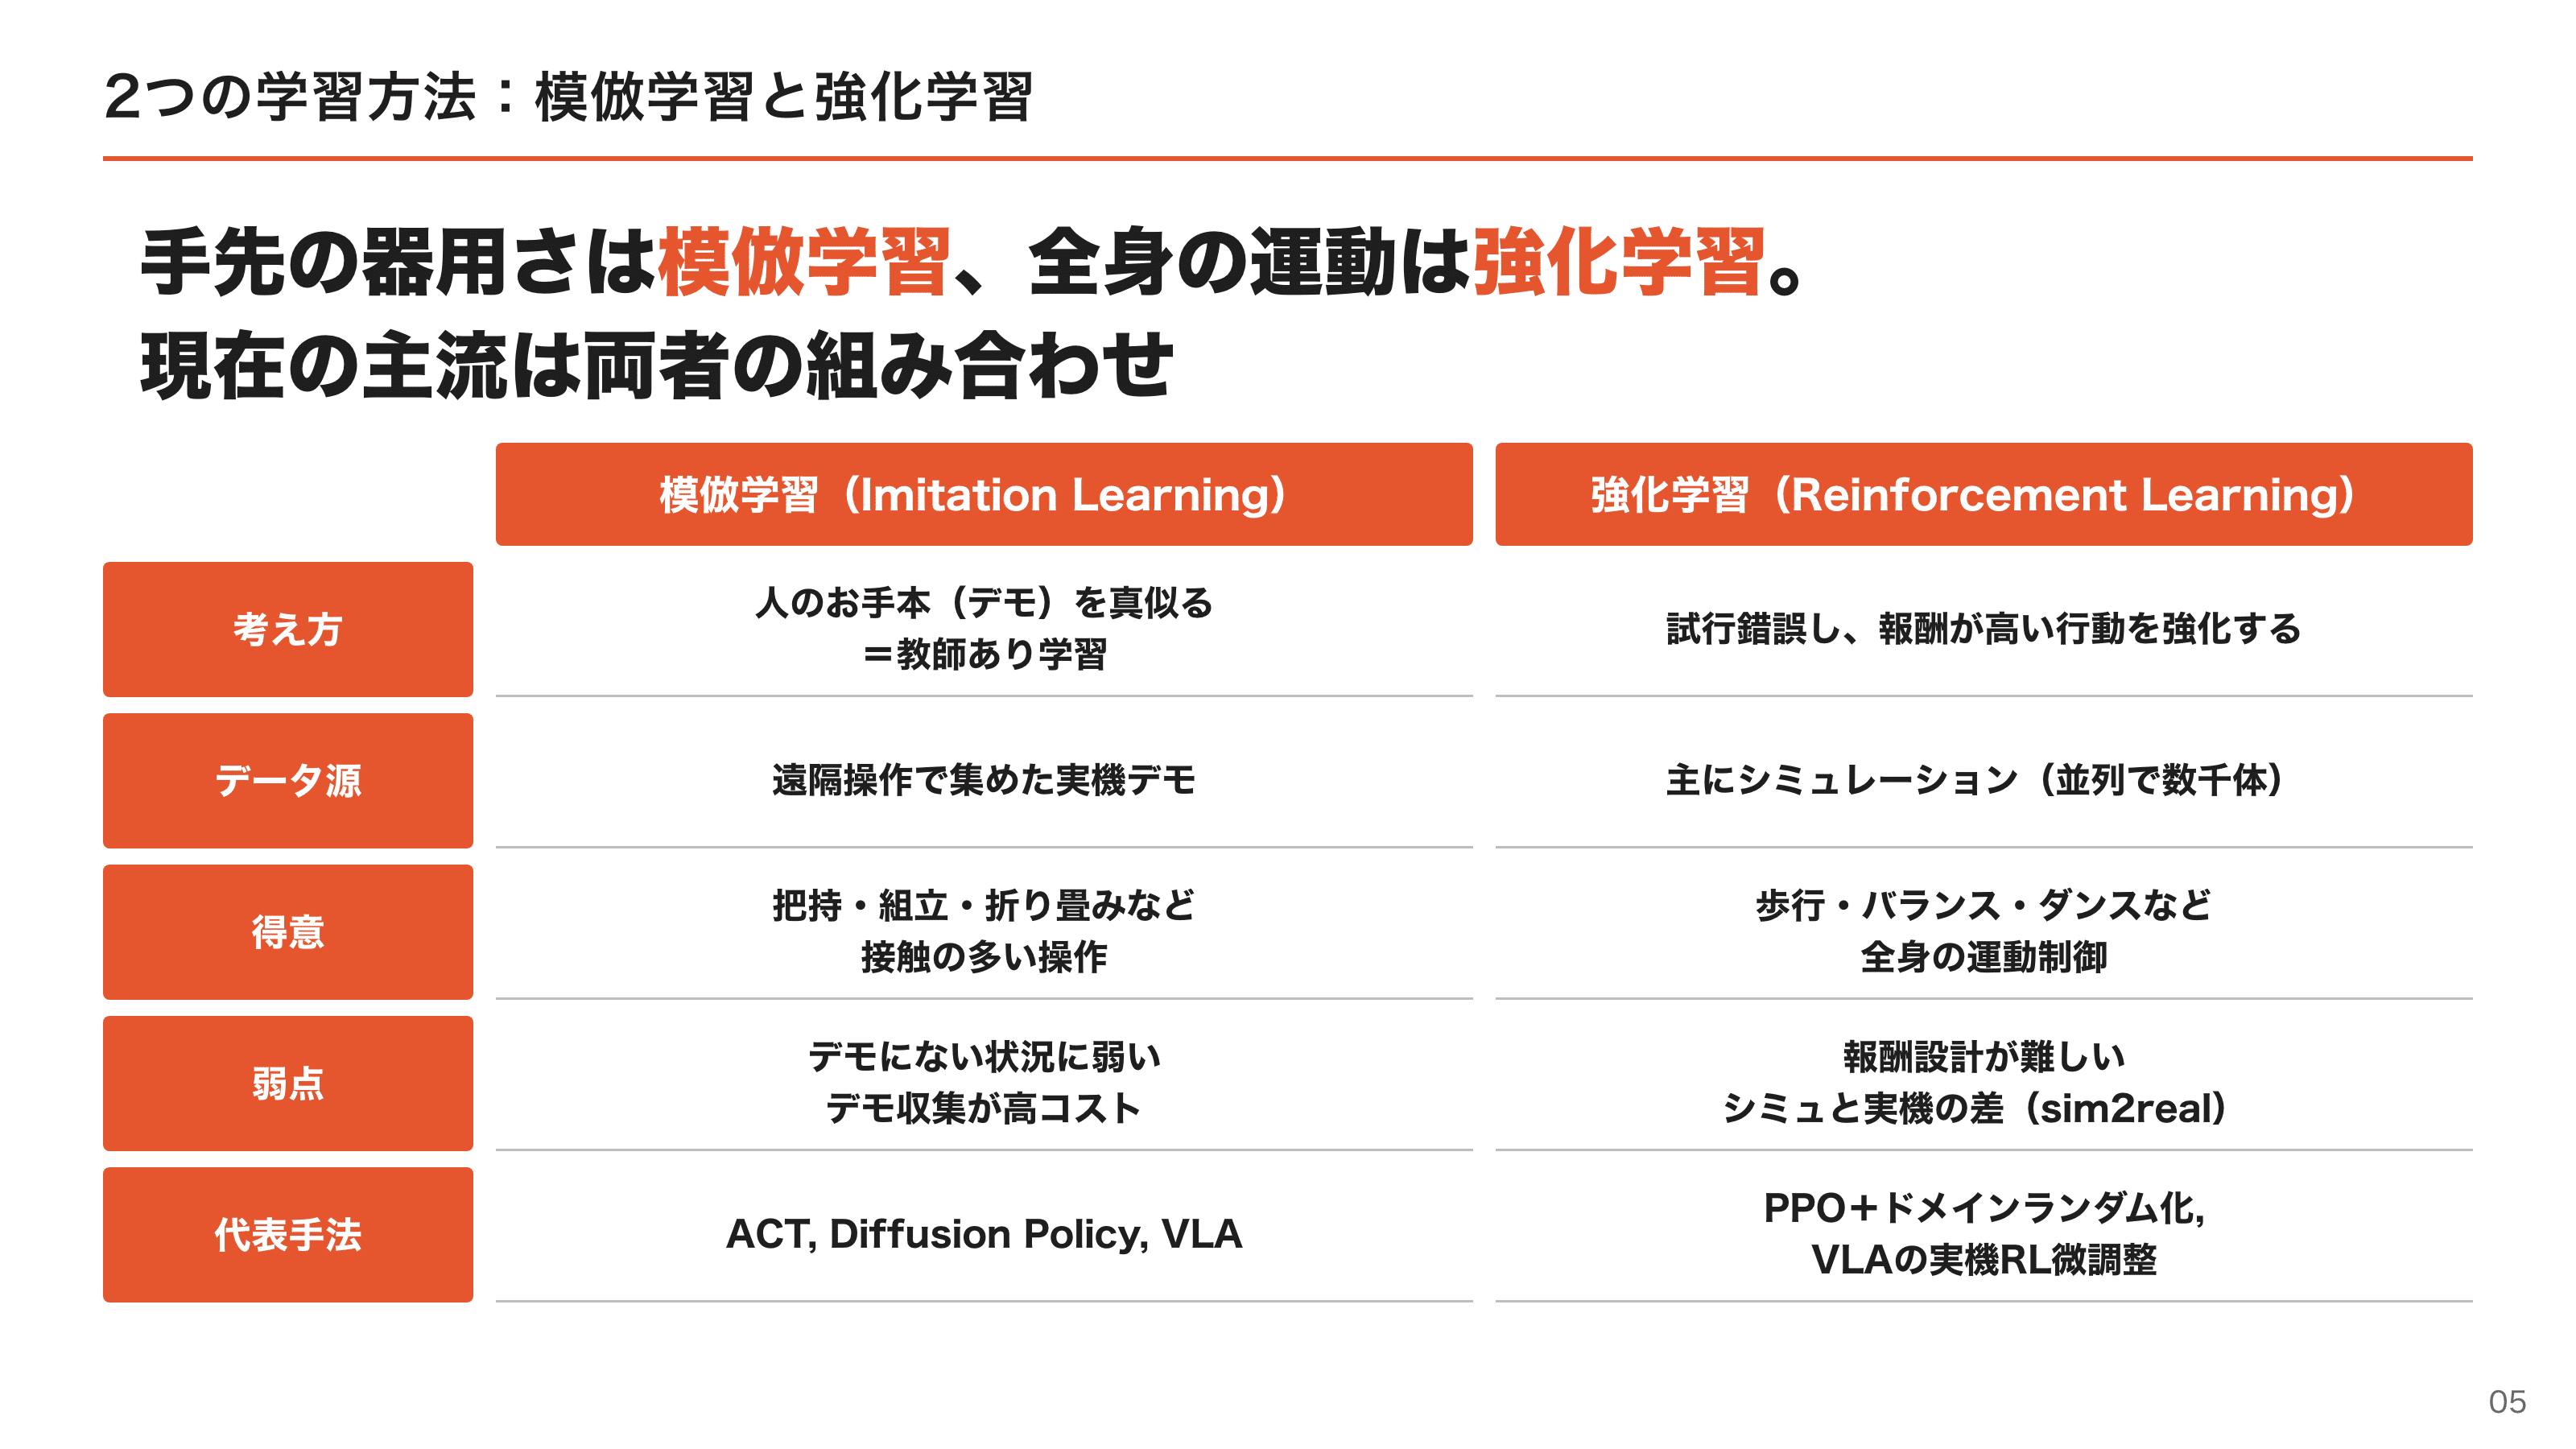
模倣学習(Imitation Learning)
人がお手本を見せ、ロボットがそれを真似る方法です。機械学習としては教師あり学習そのもので、「この画像のとき、この関節角に動かす」という入力と正解のペアを大量に学びます。
お手本の集め方として主流なのが遠隔操作(テレオペレーション)です。人がVRゴーグルや、ロボットと同じ形をした操作用のアームを動かし、ロボットに同じ動きをさせて記録します。
模倣学習を実用レベルに押し上げた2つの手法があります。
ACT(Action Chunking with Transformers、2023年):スタンフォード大学のALOHAプロジェクトで提案。1ステップずつではなく、未来の数十ステップ分の動きをまとめて(チャンクで)予測します。予測誤差の積み重なりを抑え、数十回のデモで電池をはめ込むような精密作業を学べることを示しました。
Diffusion Policy(2023年):画像生成で使われる拡散モデルを行動の生成に応用した手法。同じ状況でも「右から回り込む」「左から回り込む」のように正解が複数ある場面で、平均を取って中途半端な動きになる問題を解決しました。
この「行動をチャンクで出す」「拡散モデル系の手法で連続的な行動を生成する」という2つのアイデアは、次に説明するVLAにそのまま受け継がれています。
強化学習(Reinforcement Learning)
ロボット自身が試行錯誤し、報酬(「倒れずに進んだら+1」など)が高くなる行動を強化していく方法です。シミュレーションで学習してから実機に移す(sim2real)のが基本です。
シミュレーションと現実の差を埋めるため、摩擦・重さ・センサーのノイズなどをランダムに変えながら学習させるドメインランダム化が使われます。「どんな世界でも歩けるように鍛えれば、現実もその1つとして歩ける」という発想です。近年の人型ロボットの歩行、バク転、ダンスの映像の多くは、この方法で作られています。
手先の器用さ(マニピュレーション)は模倣学習、全身の運動(ロコモーション)は強化学習、というのが2026年時点の大まかな分担です。さらに、模倣学習で作ったモデルを実機での強化学習で磨く組み合わせが、性能向上の主戦場になっています。
3.3 VLA:ロボットの基盤モデル
2026年のPhysical AIの中心にあるのがVLA(Vision-Language-Action)モデルです。名前のとおり、画像(Vision)と言語(Language)を入力し、行動(Action)を出力するモデルです。
基本構造:VLM+行動エキスパート
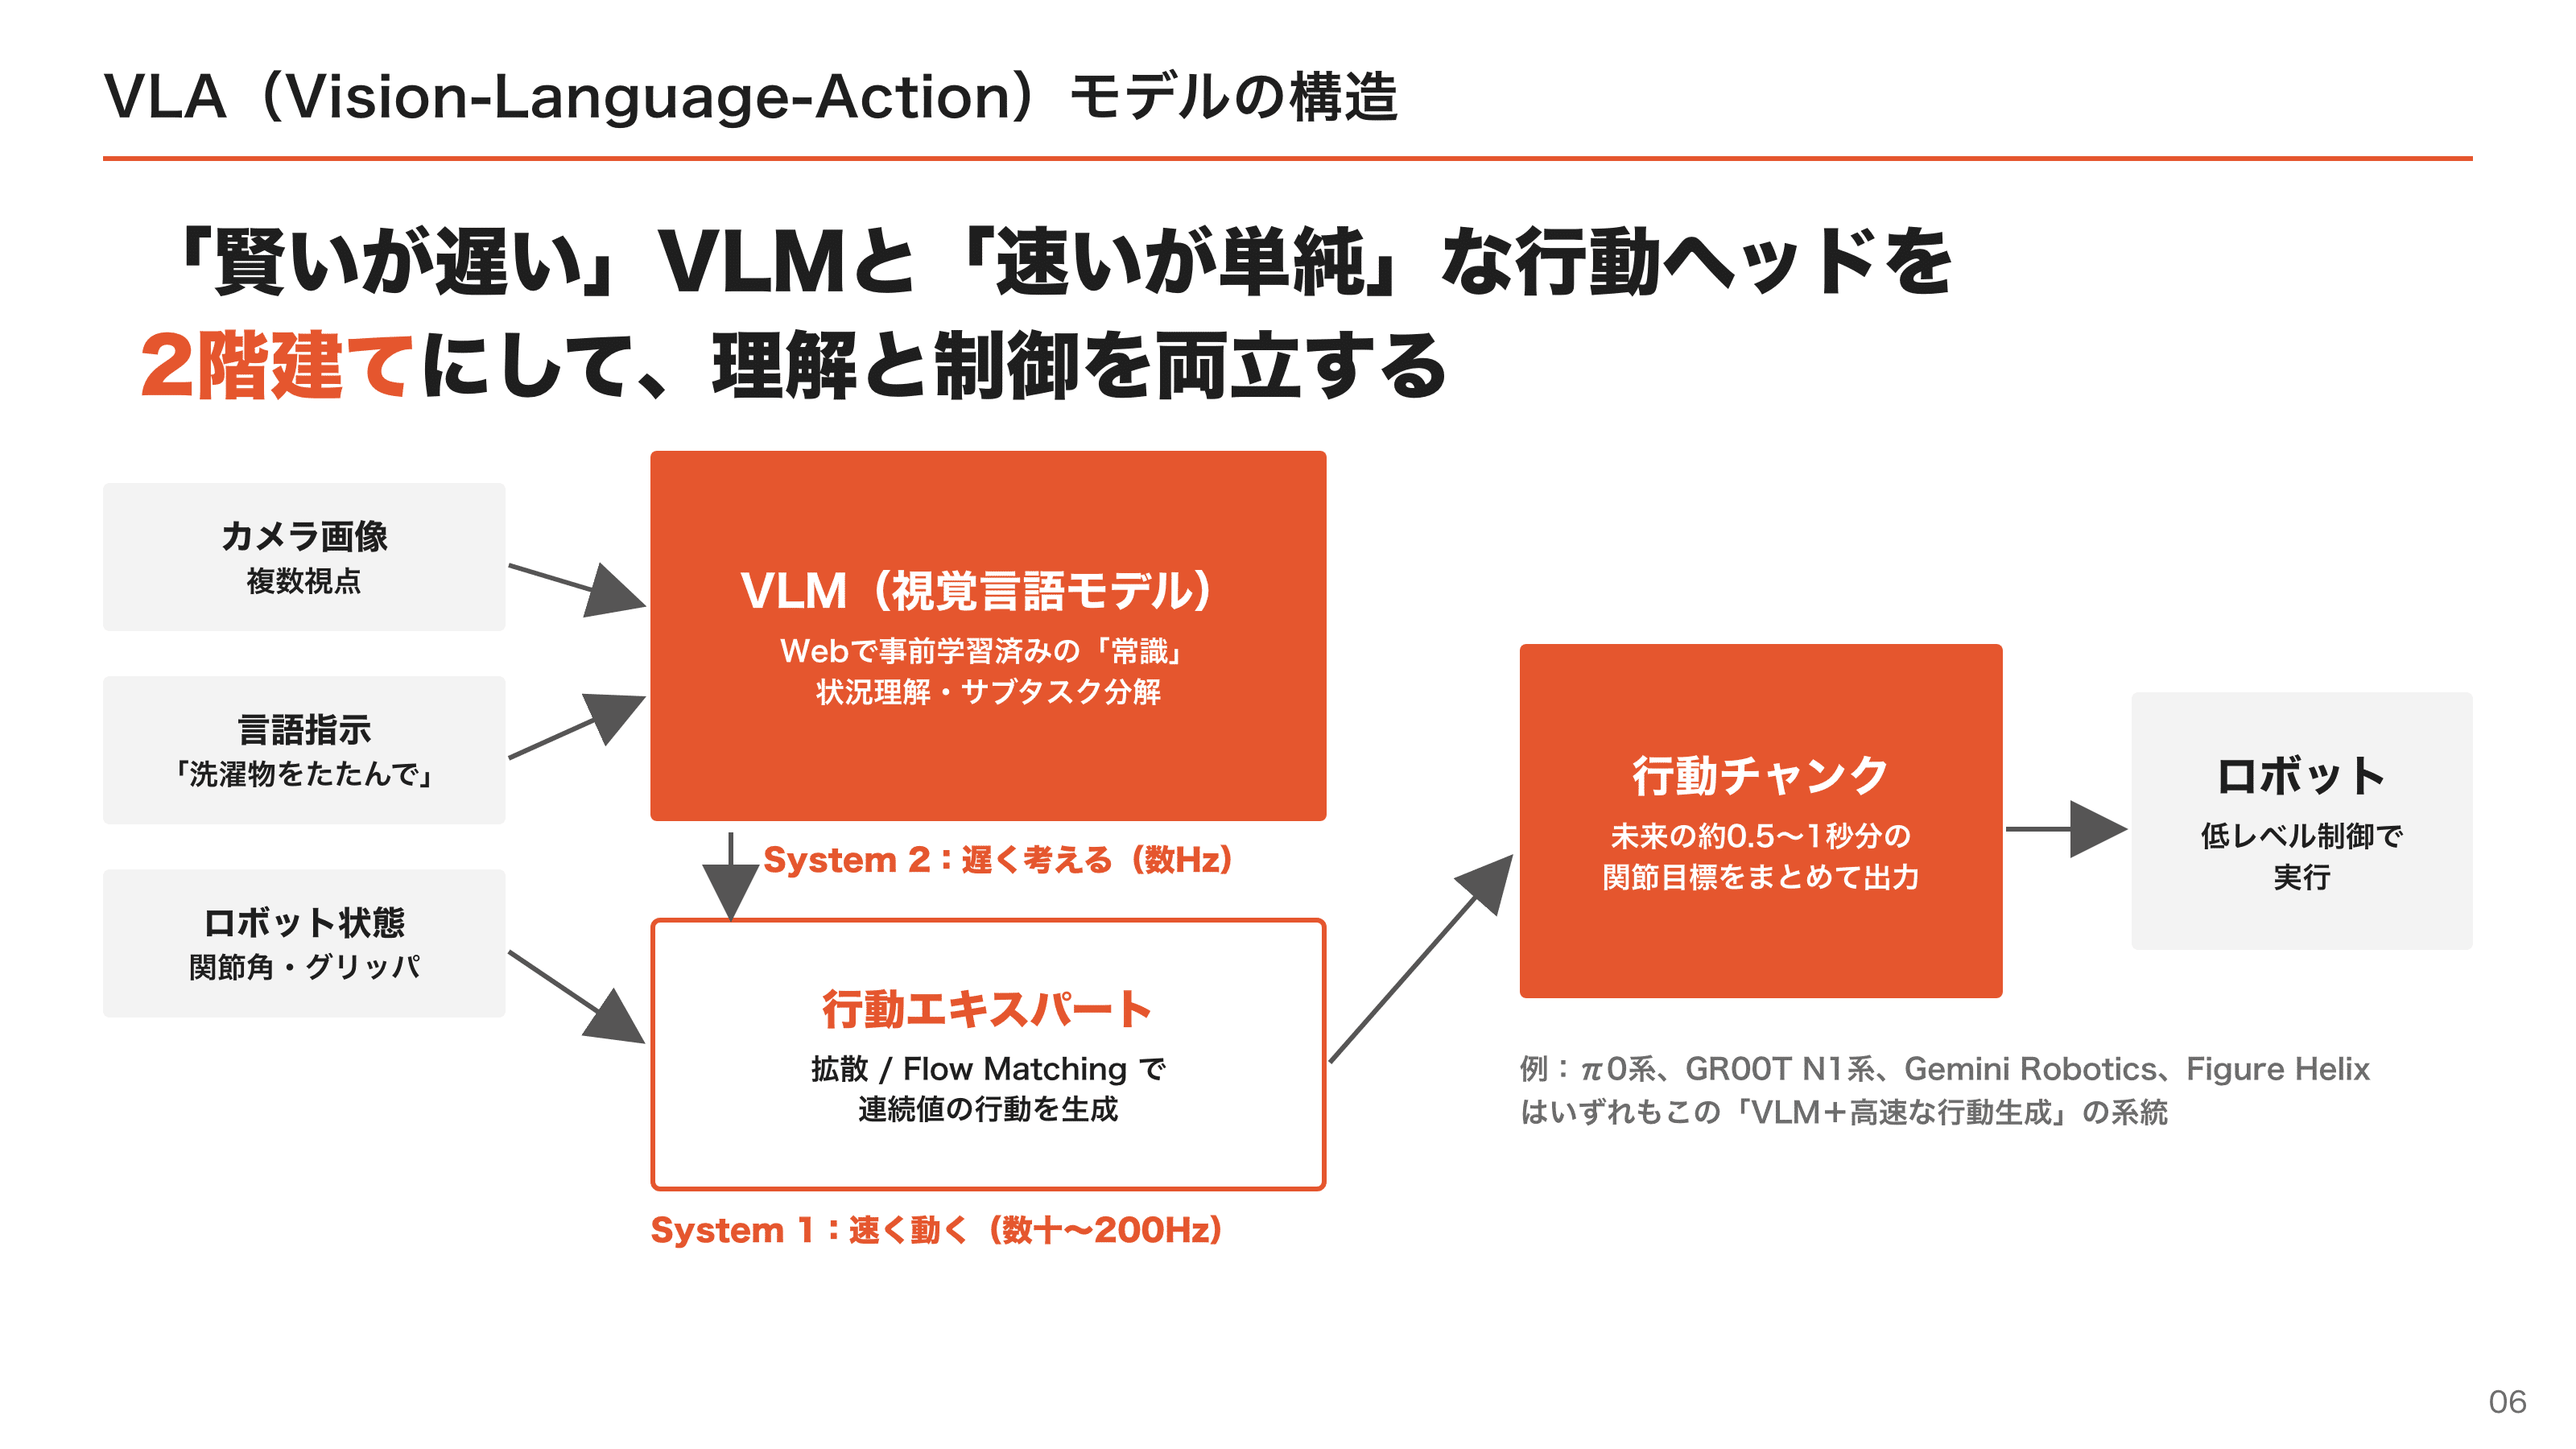
現在の主要なVLAは、ほぼ共通して2階建ての構造をとっています。
上の階:VLM(System 2) Webで事前学習した視覚言語モデル。カメラ画像と指示文から「今どんな状況で、次に何をすべきか」を理解します。賢いが重く、1秒に数回しか回せません。
下の階:行動エキスパート(System 1) VLMの理解を受け取り、実際の関節の動きを高速に生成する小さめのネットワーク。数十〜200Hzで動きます。
System 2とSystem 1は、心理学者カーネマンの「遅い思考/速い思考」から借りた呼び方です。たとえばFigureのHelixは、7BパラメータのVLMを7〜9Hzで、8,000万パラメータの制御ネットワークを200Hzで動かしています。2026年1月のHelix 02では、さらに下に1kHzで全身のバランスを取る1,000万パラメータの層(System 0)を追加し、従来のC++による制御コード約11万行を学習モデルに置き換えたと発表しました。
行動をどう出力するか
LLMは単語を1つずつ(トークンで)出力します。初期のVLAも同じ発想で、関節角を256段階などに区切ってトークンとして出力していました(RT-2、OpenVLA)。シンプルですが、滑らかで精密な動きには向きません。
現在の主流は、3.2で紹介した2つのアイデアの組み合わせです。
Flow Matching/拡散モデルで連続値の行動を直接生成する(画像生成と同じ仕組みで「動き」を生成する)
行動チャンクとして、未来の約0.5〜1秒分の動きをまとめて出す
Physical IntelligenceのVLA「π0(パイゼロ)」は、30億パラメータのVLM(PaliGemma)に約3億パラメータの行動エキスパートを付け、Flow Matchingで50Hzの行動チャンクを生成します。NVIDIAのGR00T N1系、Hugging FaceのSmolVLAも同じ系統です。
系譜:3年で何が起きた?
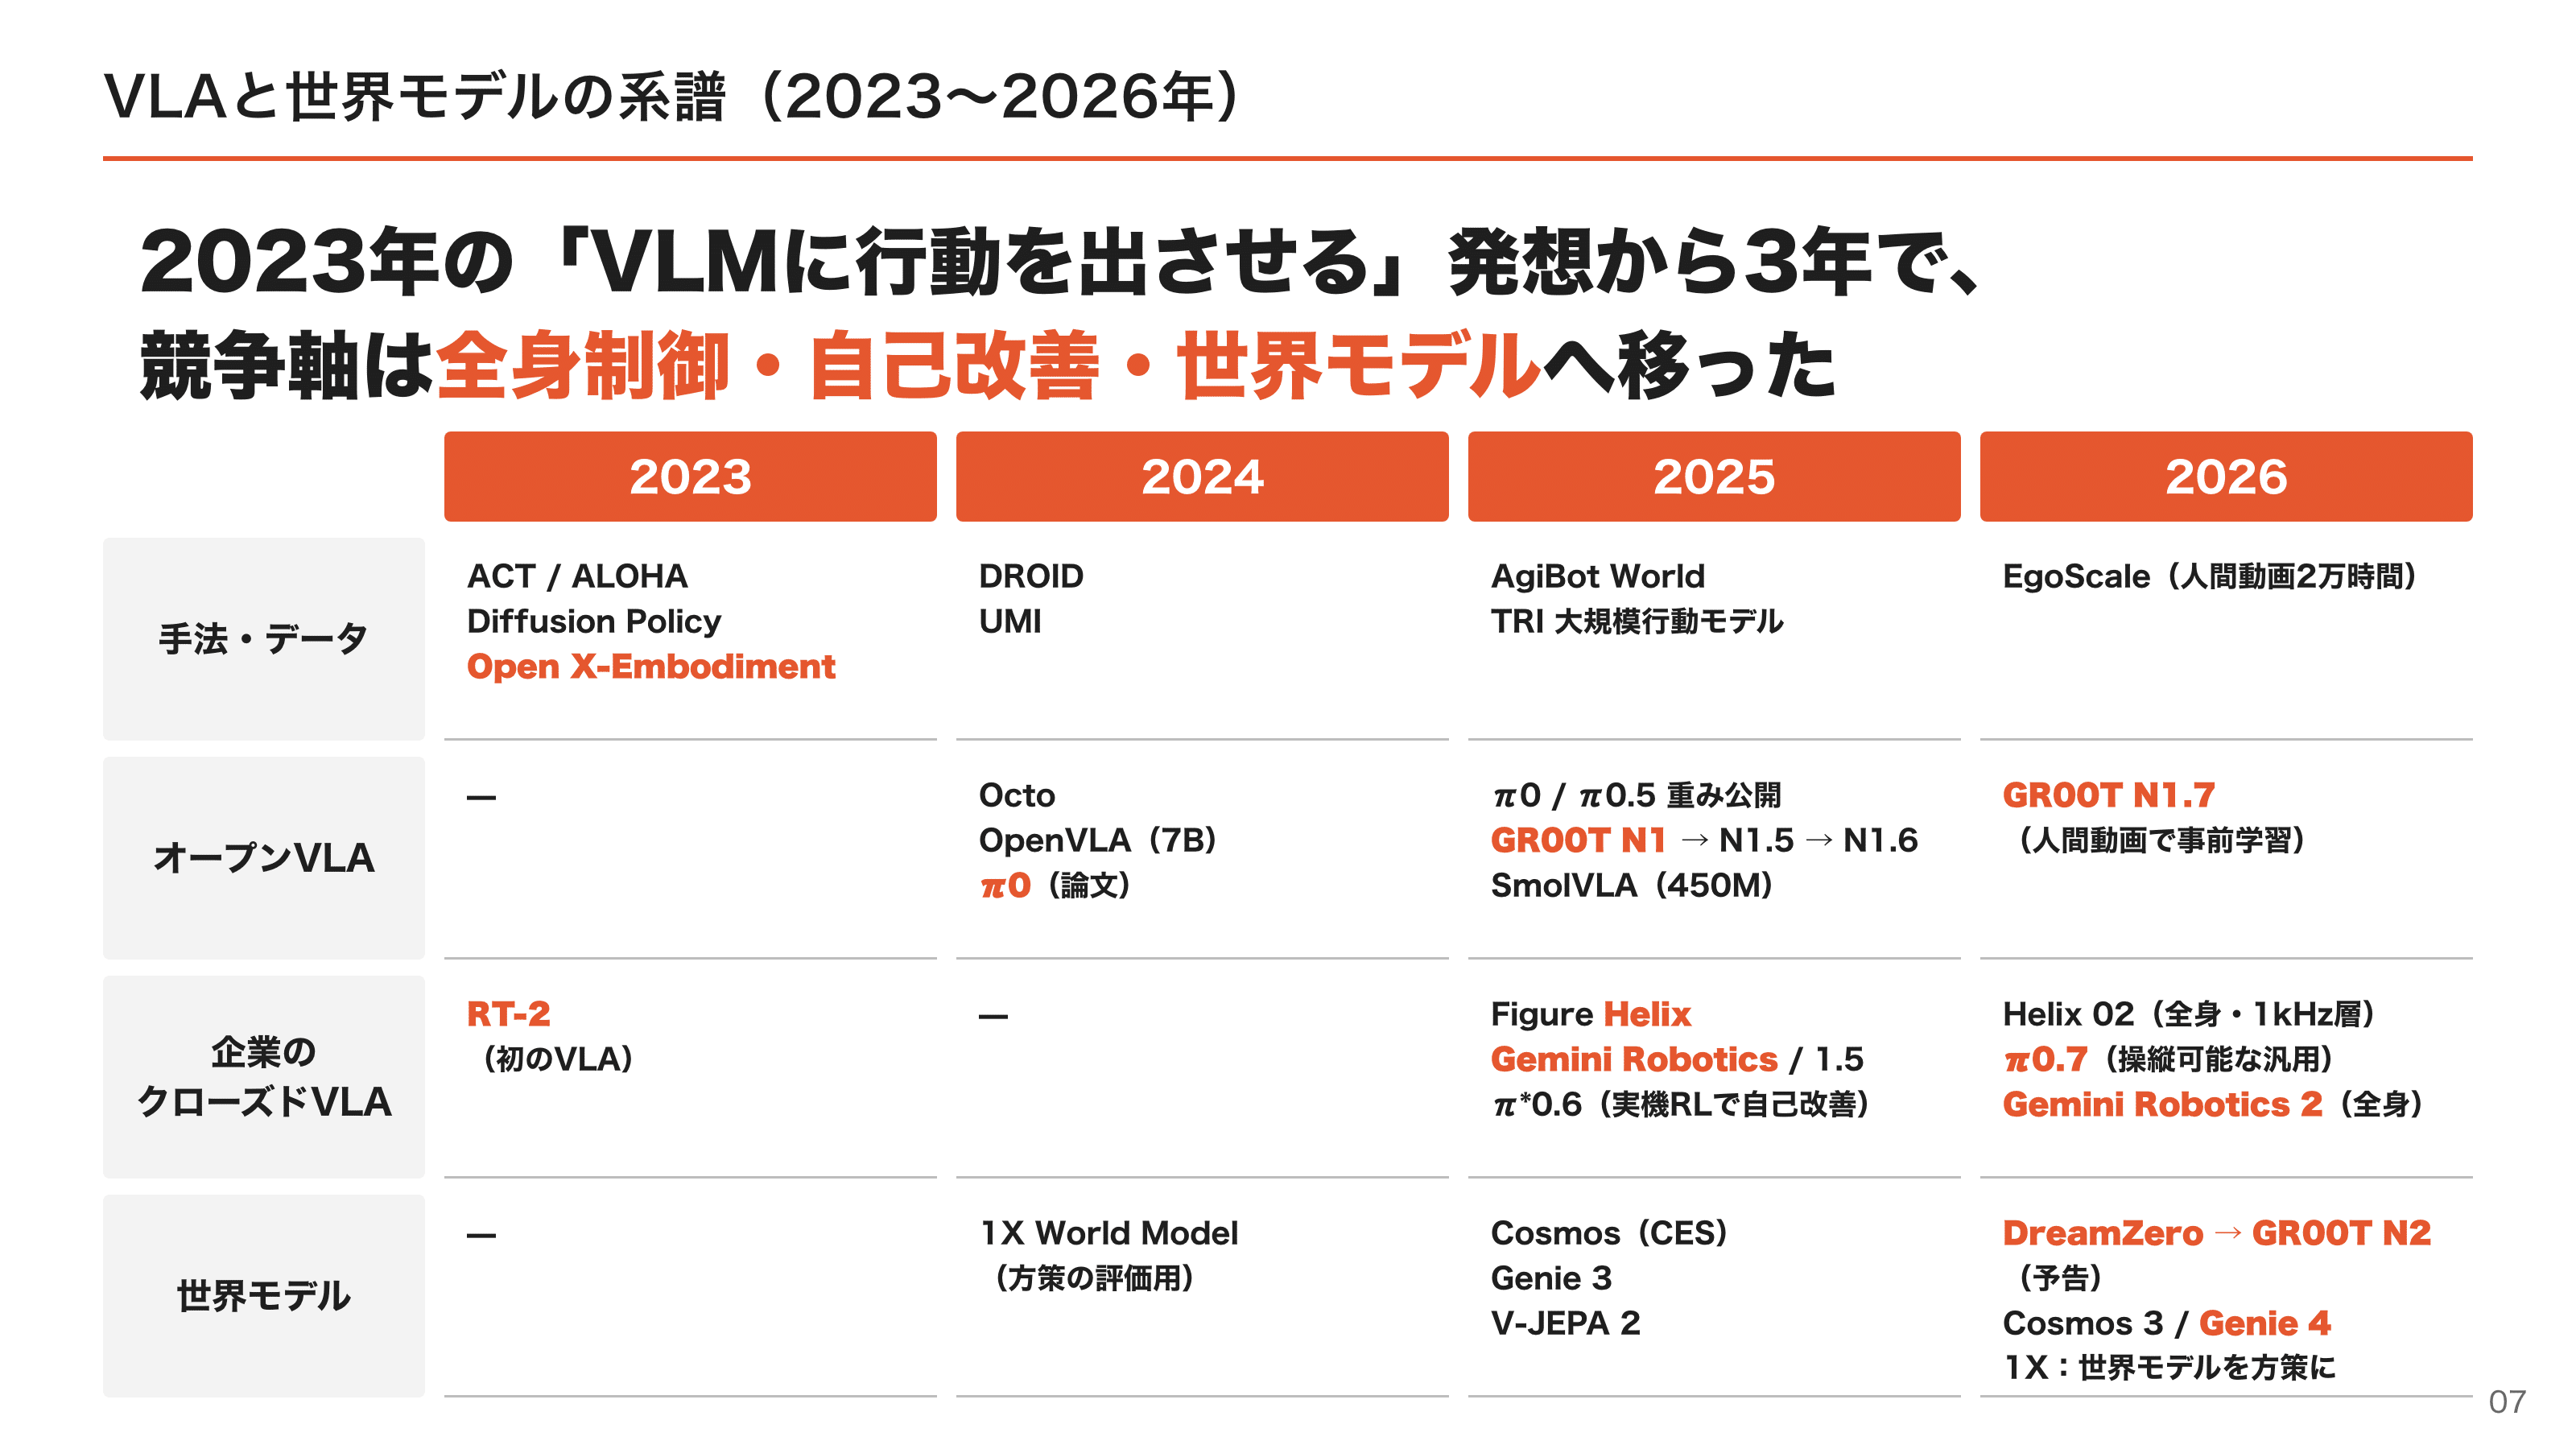
主要なモデルを時系列で押さえます。
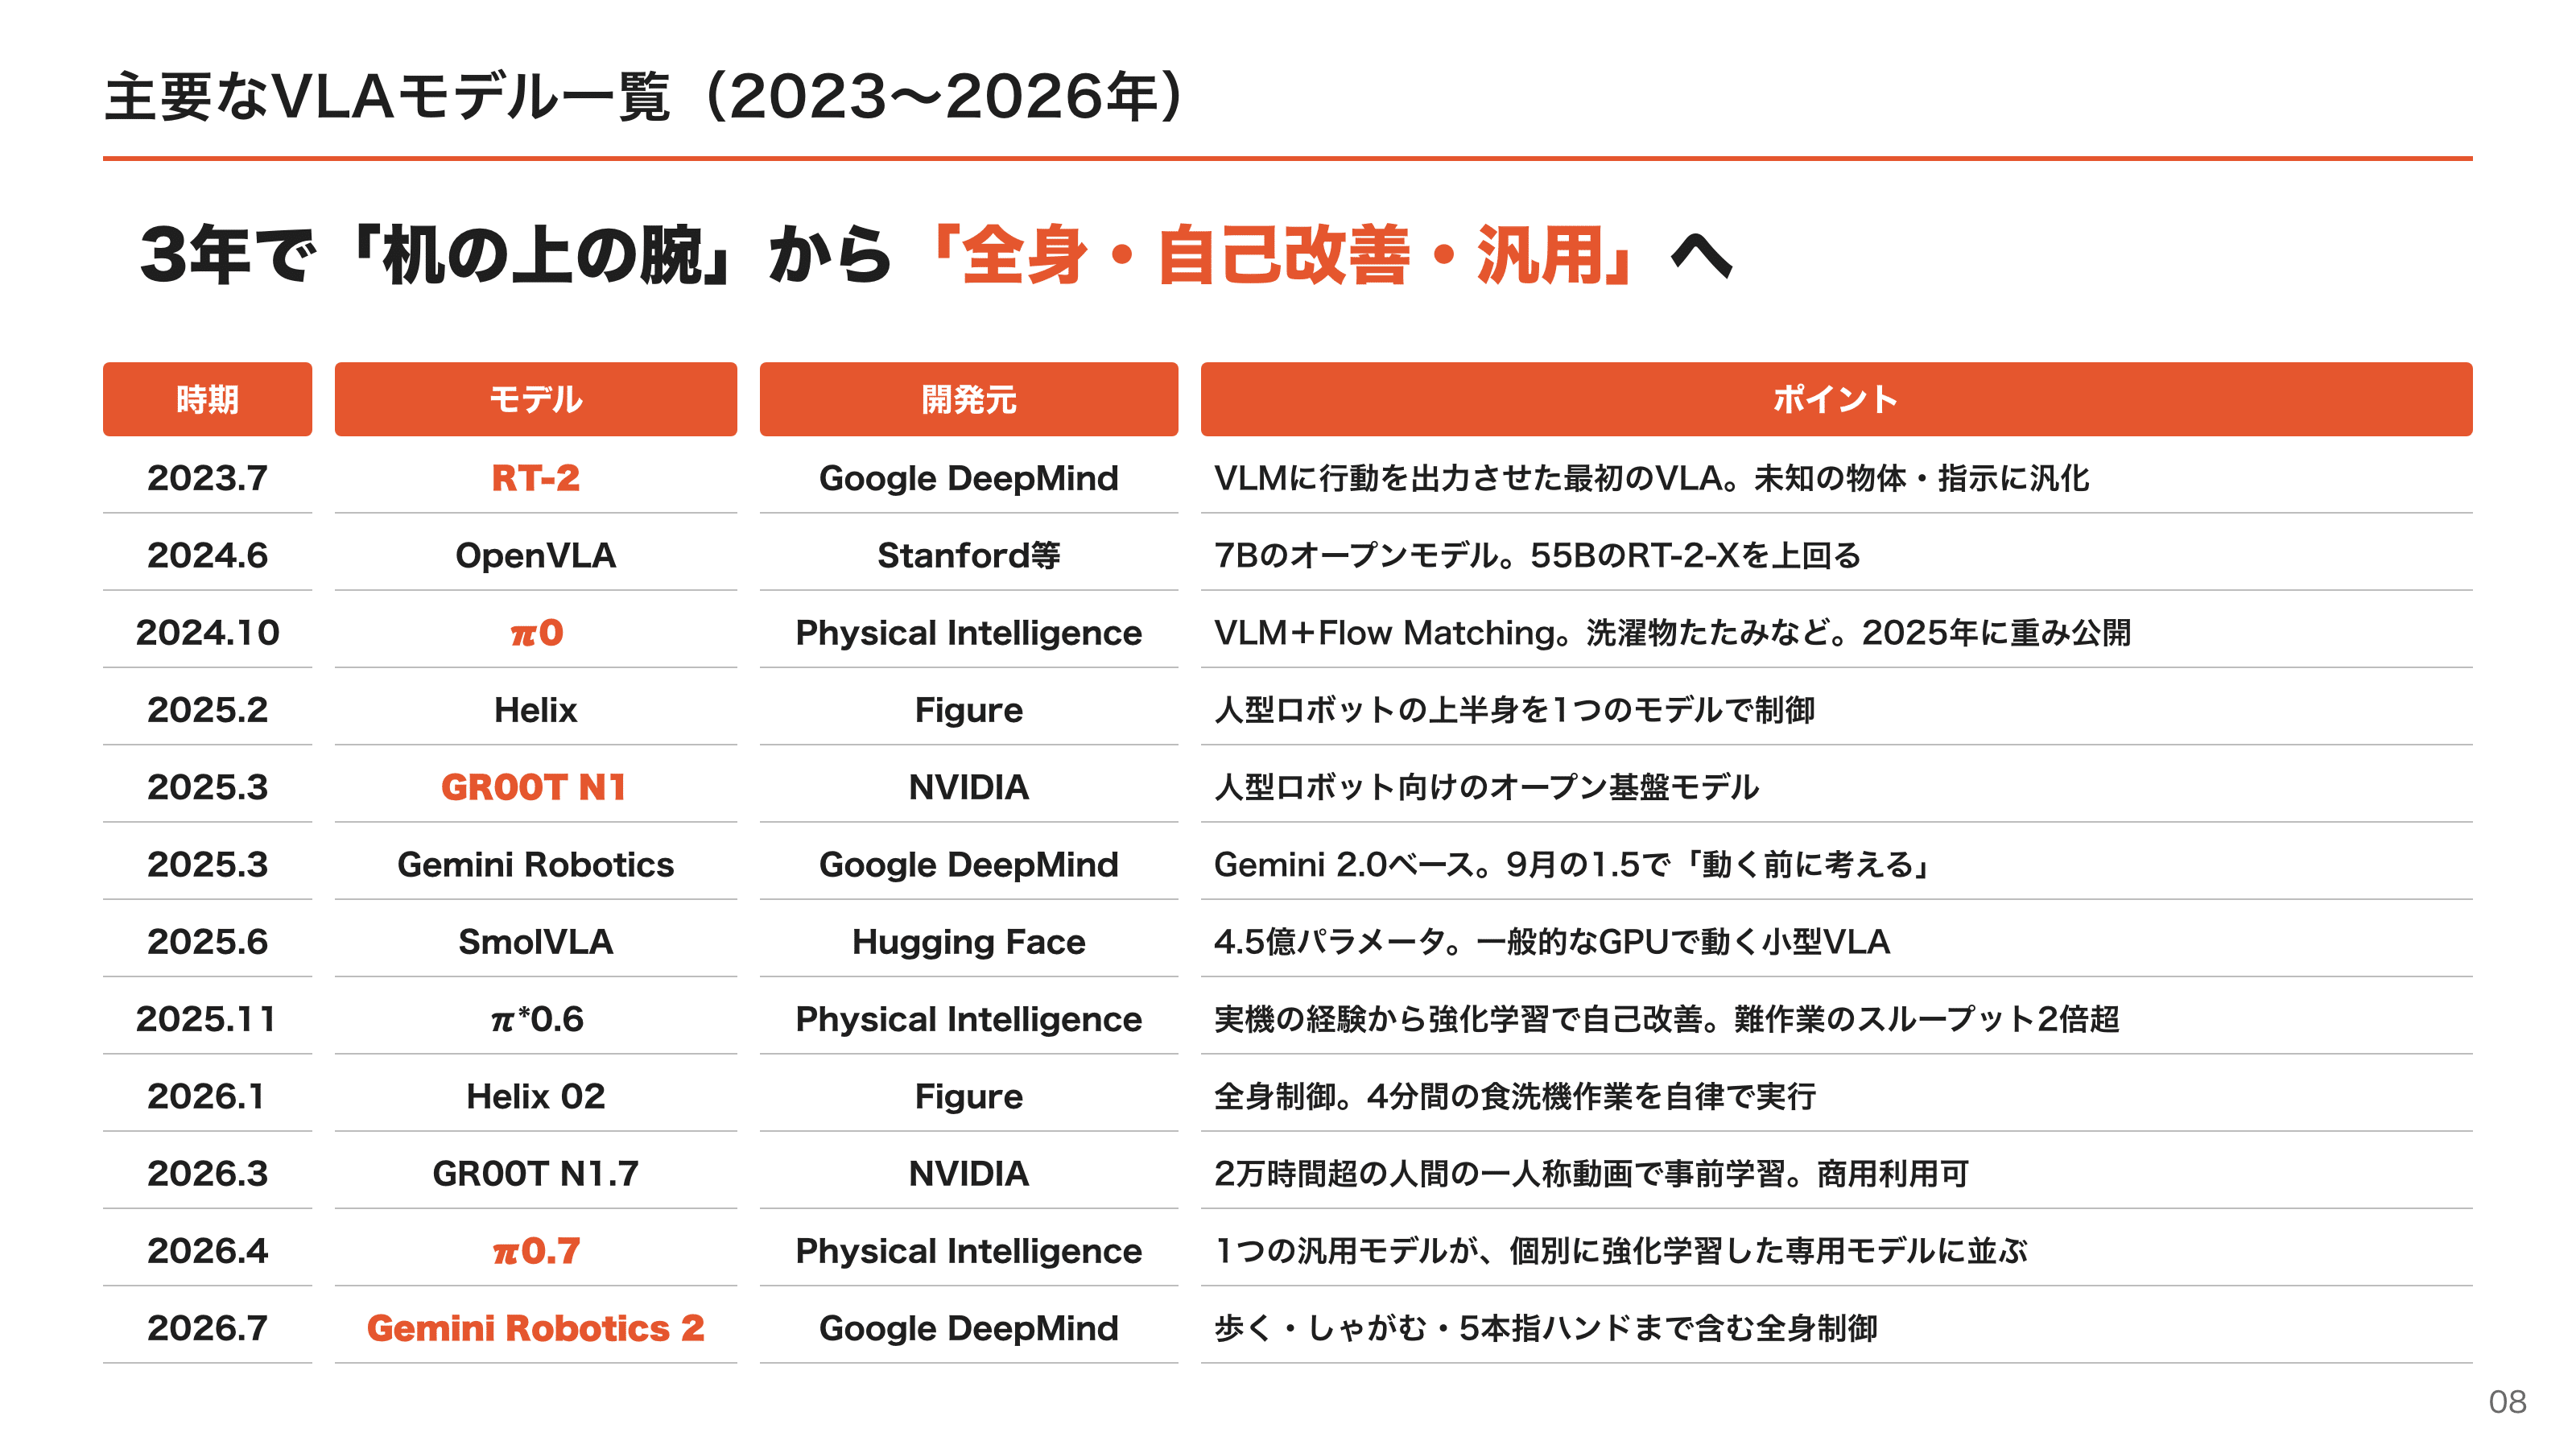
この流れから、2026年の競争軸が3つ読み取れます。
腕から全身へ:机の上のアーム操作から、歩きながら・しゃがみながら物を扱う全身制御へ(Helix 02、Gemini Robotics 2)。
真似から自己改善へ:人のデモを真似るだけでなく、実機で働いた経験から強化学習で上達する(π*0.6)。LLMにおけるRLHFや推論モデルの登場と同じ流れです。
専用から汎用へ:タスクごとにモデルを作るのではなく、1つのモデルを言語や目標画像で「操縦」して使い分ける(π0.7)。
オープンとクローズド
LLMと同様、VLAにもオープンモデルとクローズドモデルがあります。
オープン(重み公開):π0/π0.5(openpi、Apache-2.0)、GR00T N1.x(NVIDIA)、SmolVLA、OpenVLA。手元のロボットで追加学習できます。
クローズド:Gemini Robotics(一部はAPIで提供)、Helix、π*0.6以降
Google DeepMindは、高レベルの判断を担うGemini Robotics-ERをGemini APIで公開しています。2026年4月のER 1.6はアナログメーターの読み取り精度を23%から86%に上げるなど、点検・監視の用途ならAPIを呼ぶだけで試せる段階に来ています。
VLAは「事前学習済みの基盤モデルを、自分のロボットとタスクのデータで微調整する」という、LLMとまったく同じ開発スタイルをロボットに持ち込みました。ゼロからロボット制御を学ぶ必要はなく、オープンモデルの微調整から始められます。
3.4 世界モデル:ロボットの「想像力」
VLAの次の主戦場として2026年に急浮上したのが世界モデル(World Model)です。
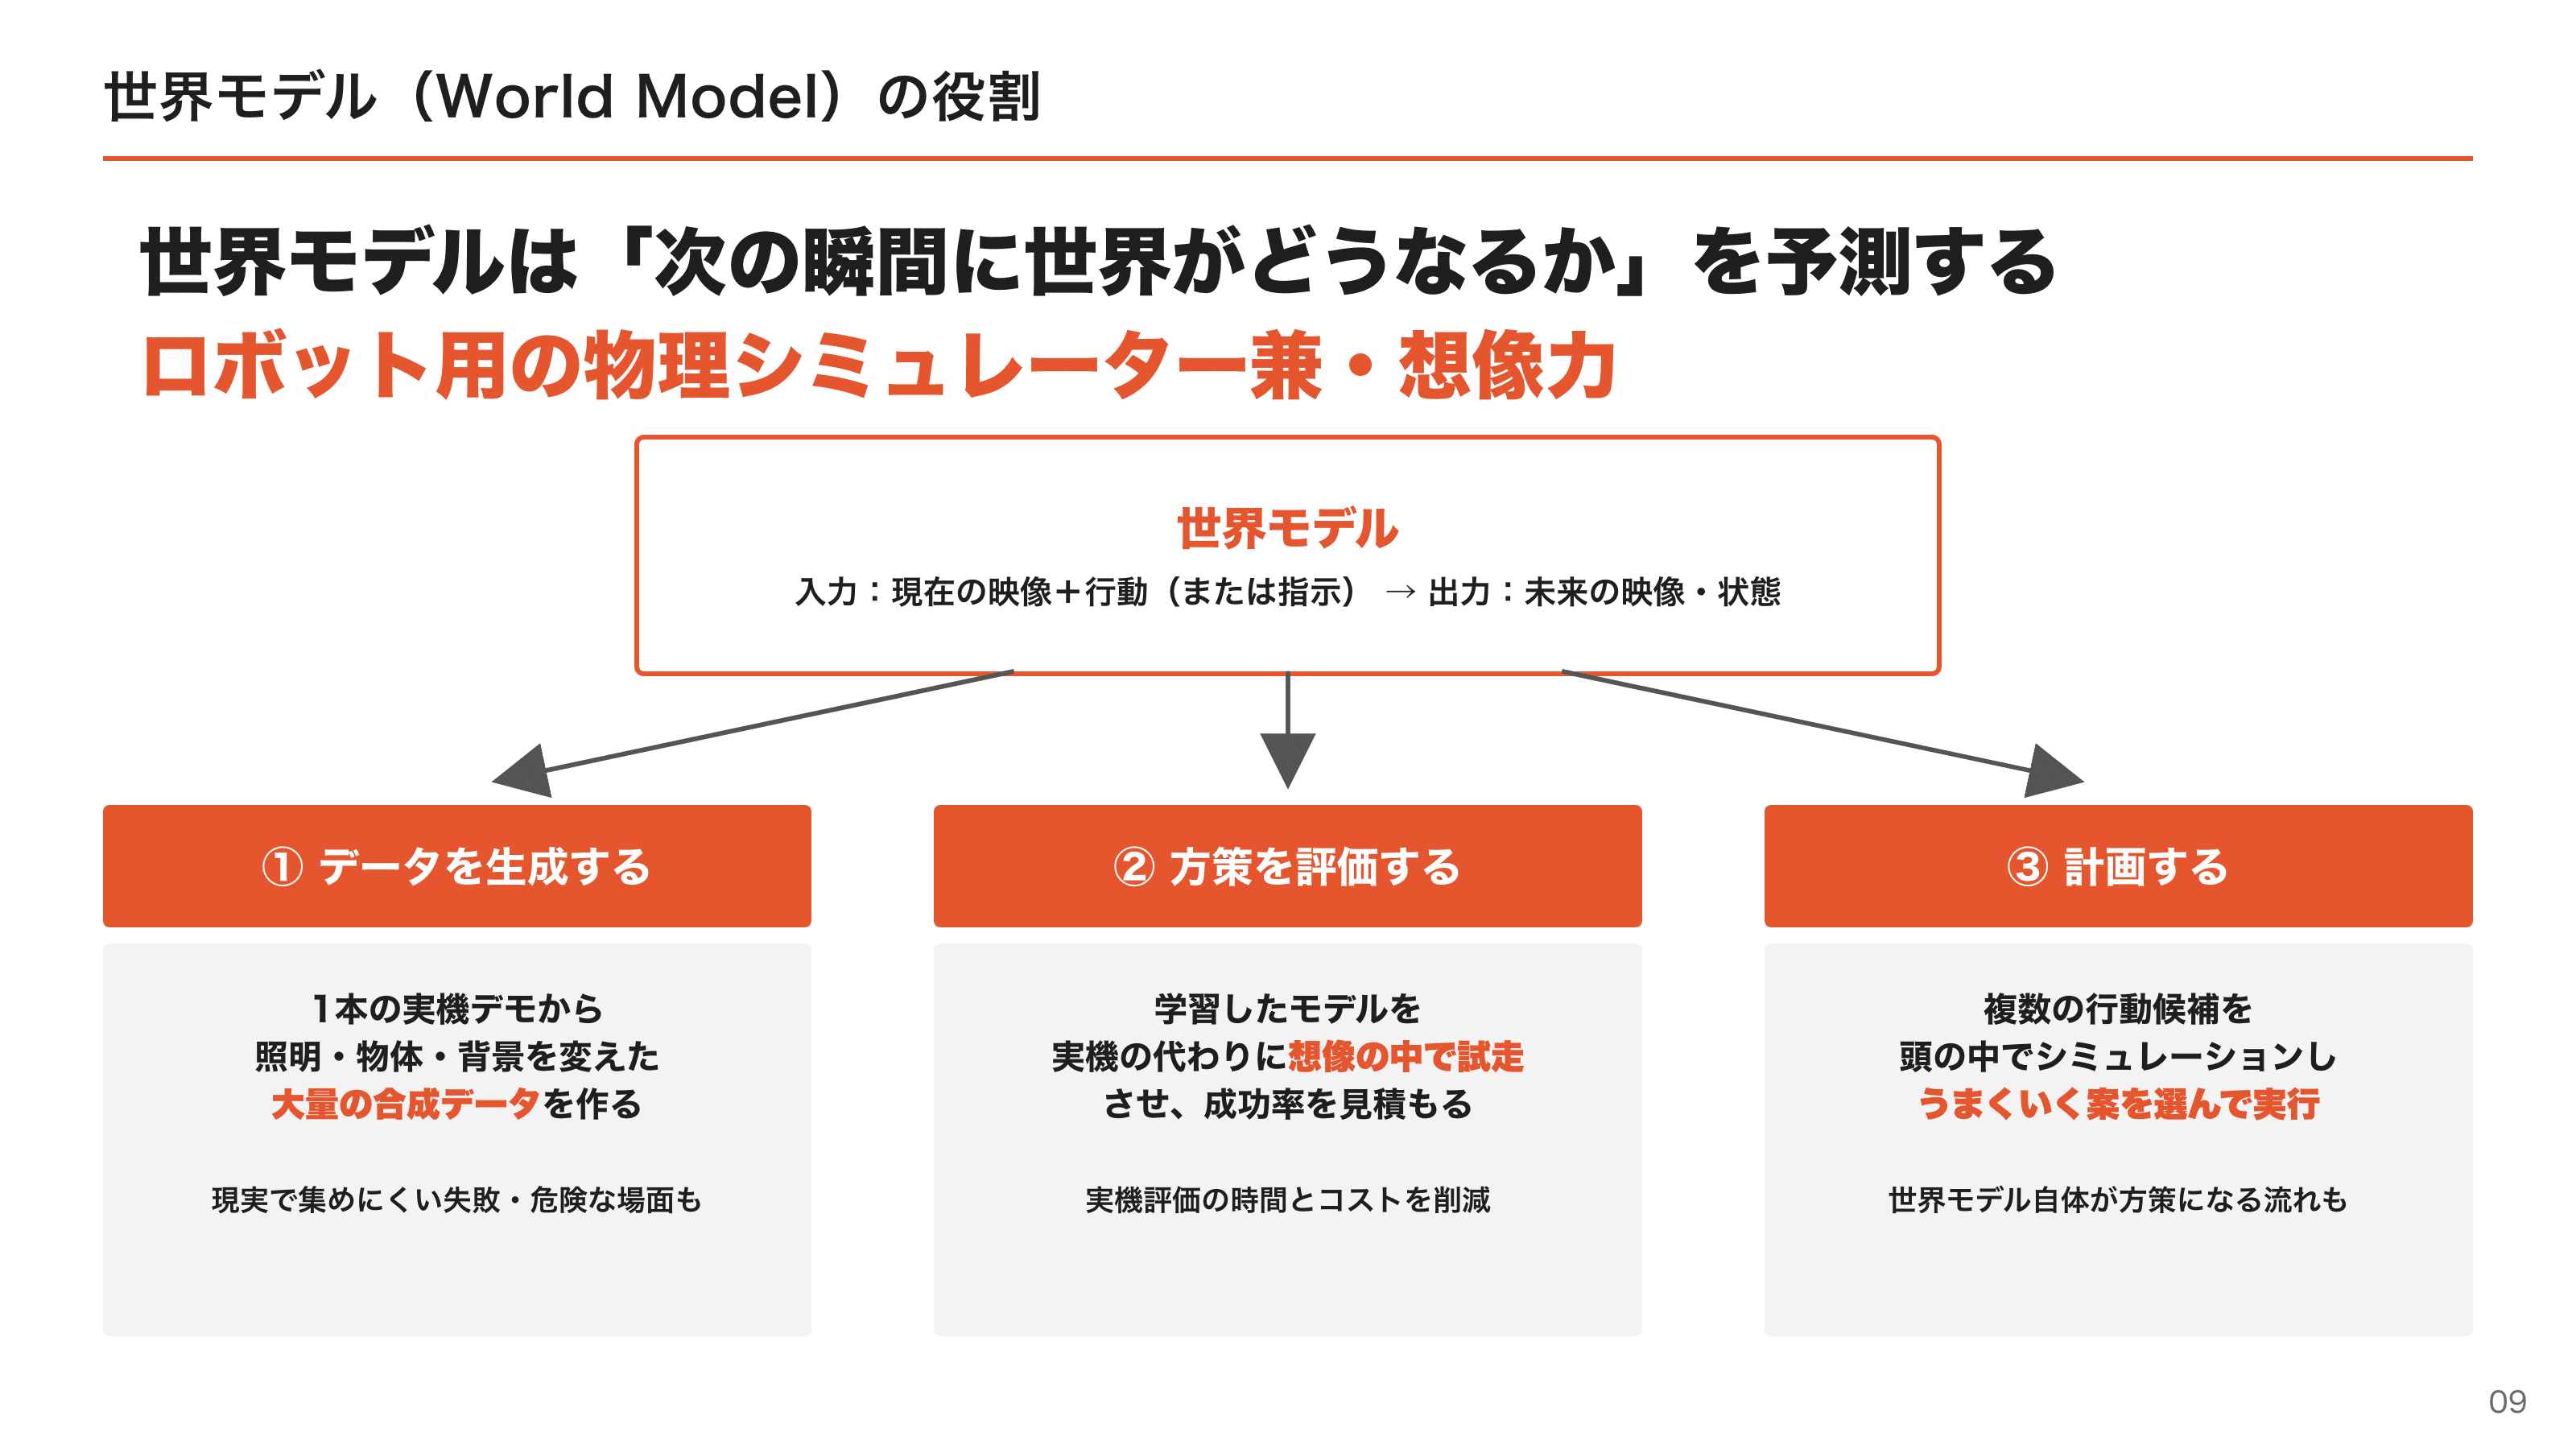
世界モデルとは、現在の映像と行動を入力すると、その結果として世界がどう変化するかを予測するモデルです。「コップを右に押したら、次の瞬間の映像はこうなる」を生成します。
用途は大きく3つあります。
データ生成:1本の実機デモから、照明・物体・背景を変えた大量の合成データを作る。NVIDIAのCosmosが代表例です。
評価:学習したモデルを実機の代わりに世界モデルの中で動かし、成功率を見積もる。1Xは2024年に、世界モデルを方策の評価に使う取り組みを公開しました。
計画と行動:行動候補を頭の中でシミュレーションし、うまくいくものを選ぶ。さらに一歩進んで、世界モデルそのものをロボットの方策(行動を決めるモデル)にする流れが出てきました。
3つ目が2026年の大きな変化です。
DreamZero(2026年2月、NVIDIA等):140億パラメータの動画生成モデルが、未来の映像と行動を同時に予測します。論文タイトルは「World Action Models are Zero-shot Policies(世界行動モデルはゼロショットで方策になる)」。NVIDIAは次世代のGR00T N2をこの構造で作ると予告し、「既存のVLAと比べ、新しいタスク・環境での成功率が2倍以上」と主張しています。
1X(2026年1月):人の一人称動画900時間とロボットのデータ70時間で学習した動画モデルが、まず「これからの動き」を映像として想像し、それを関節の動きに変換して実行する仕組みを発表しました。
Google DeepMind:インタラクティブな世界を生成するGenie 3(2025年8月)に続き、2026年10月27日にGenie 4を発表しました。ロボットやAIエージェントの訓練環境としての利用を明確に打ち出し、シミュレーション上の人型ロボットがGemini Roboticsでチェッカーをするデモを公開しています。
NVIDIA Cosmos 3:2026年3月のGTCで発表し、6月に公開しました。テキスト・画像・動画・音・行動を1つのモデルで扱う「オムニモデル」で、合成データ生成、評価、世界行動モデルの土台を兼ねます。
Meta V-JEPA 2(2025年6月):100万時間超のインターネット動画で自己教師あり学習した世界モデルです。約62時間のロボット動画を追加するだけで、初めて見る環境でのピック&プレースを計画できることを示しました。
VLAは「この状況ではこう動く」という反射を学びます。世界モデルは「こう動けばこうなる」という因果を学びます。後者は人間の動画のような行動ラベルのないデータからも学べるため、3.5で説明するデータ不足を根本から緩和する可能性があります。
3.5 データ戦略:最大のボトルネックをどう解くか
1章で述べたとおり、Physical AIの最大の制約はデータです。各社のデータ戦略は、次のピラミッドで整理できます(NVIDIAがGR00T N1の発表で示した考え方です)。
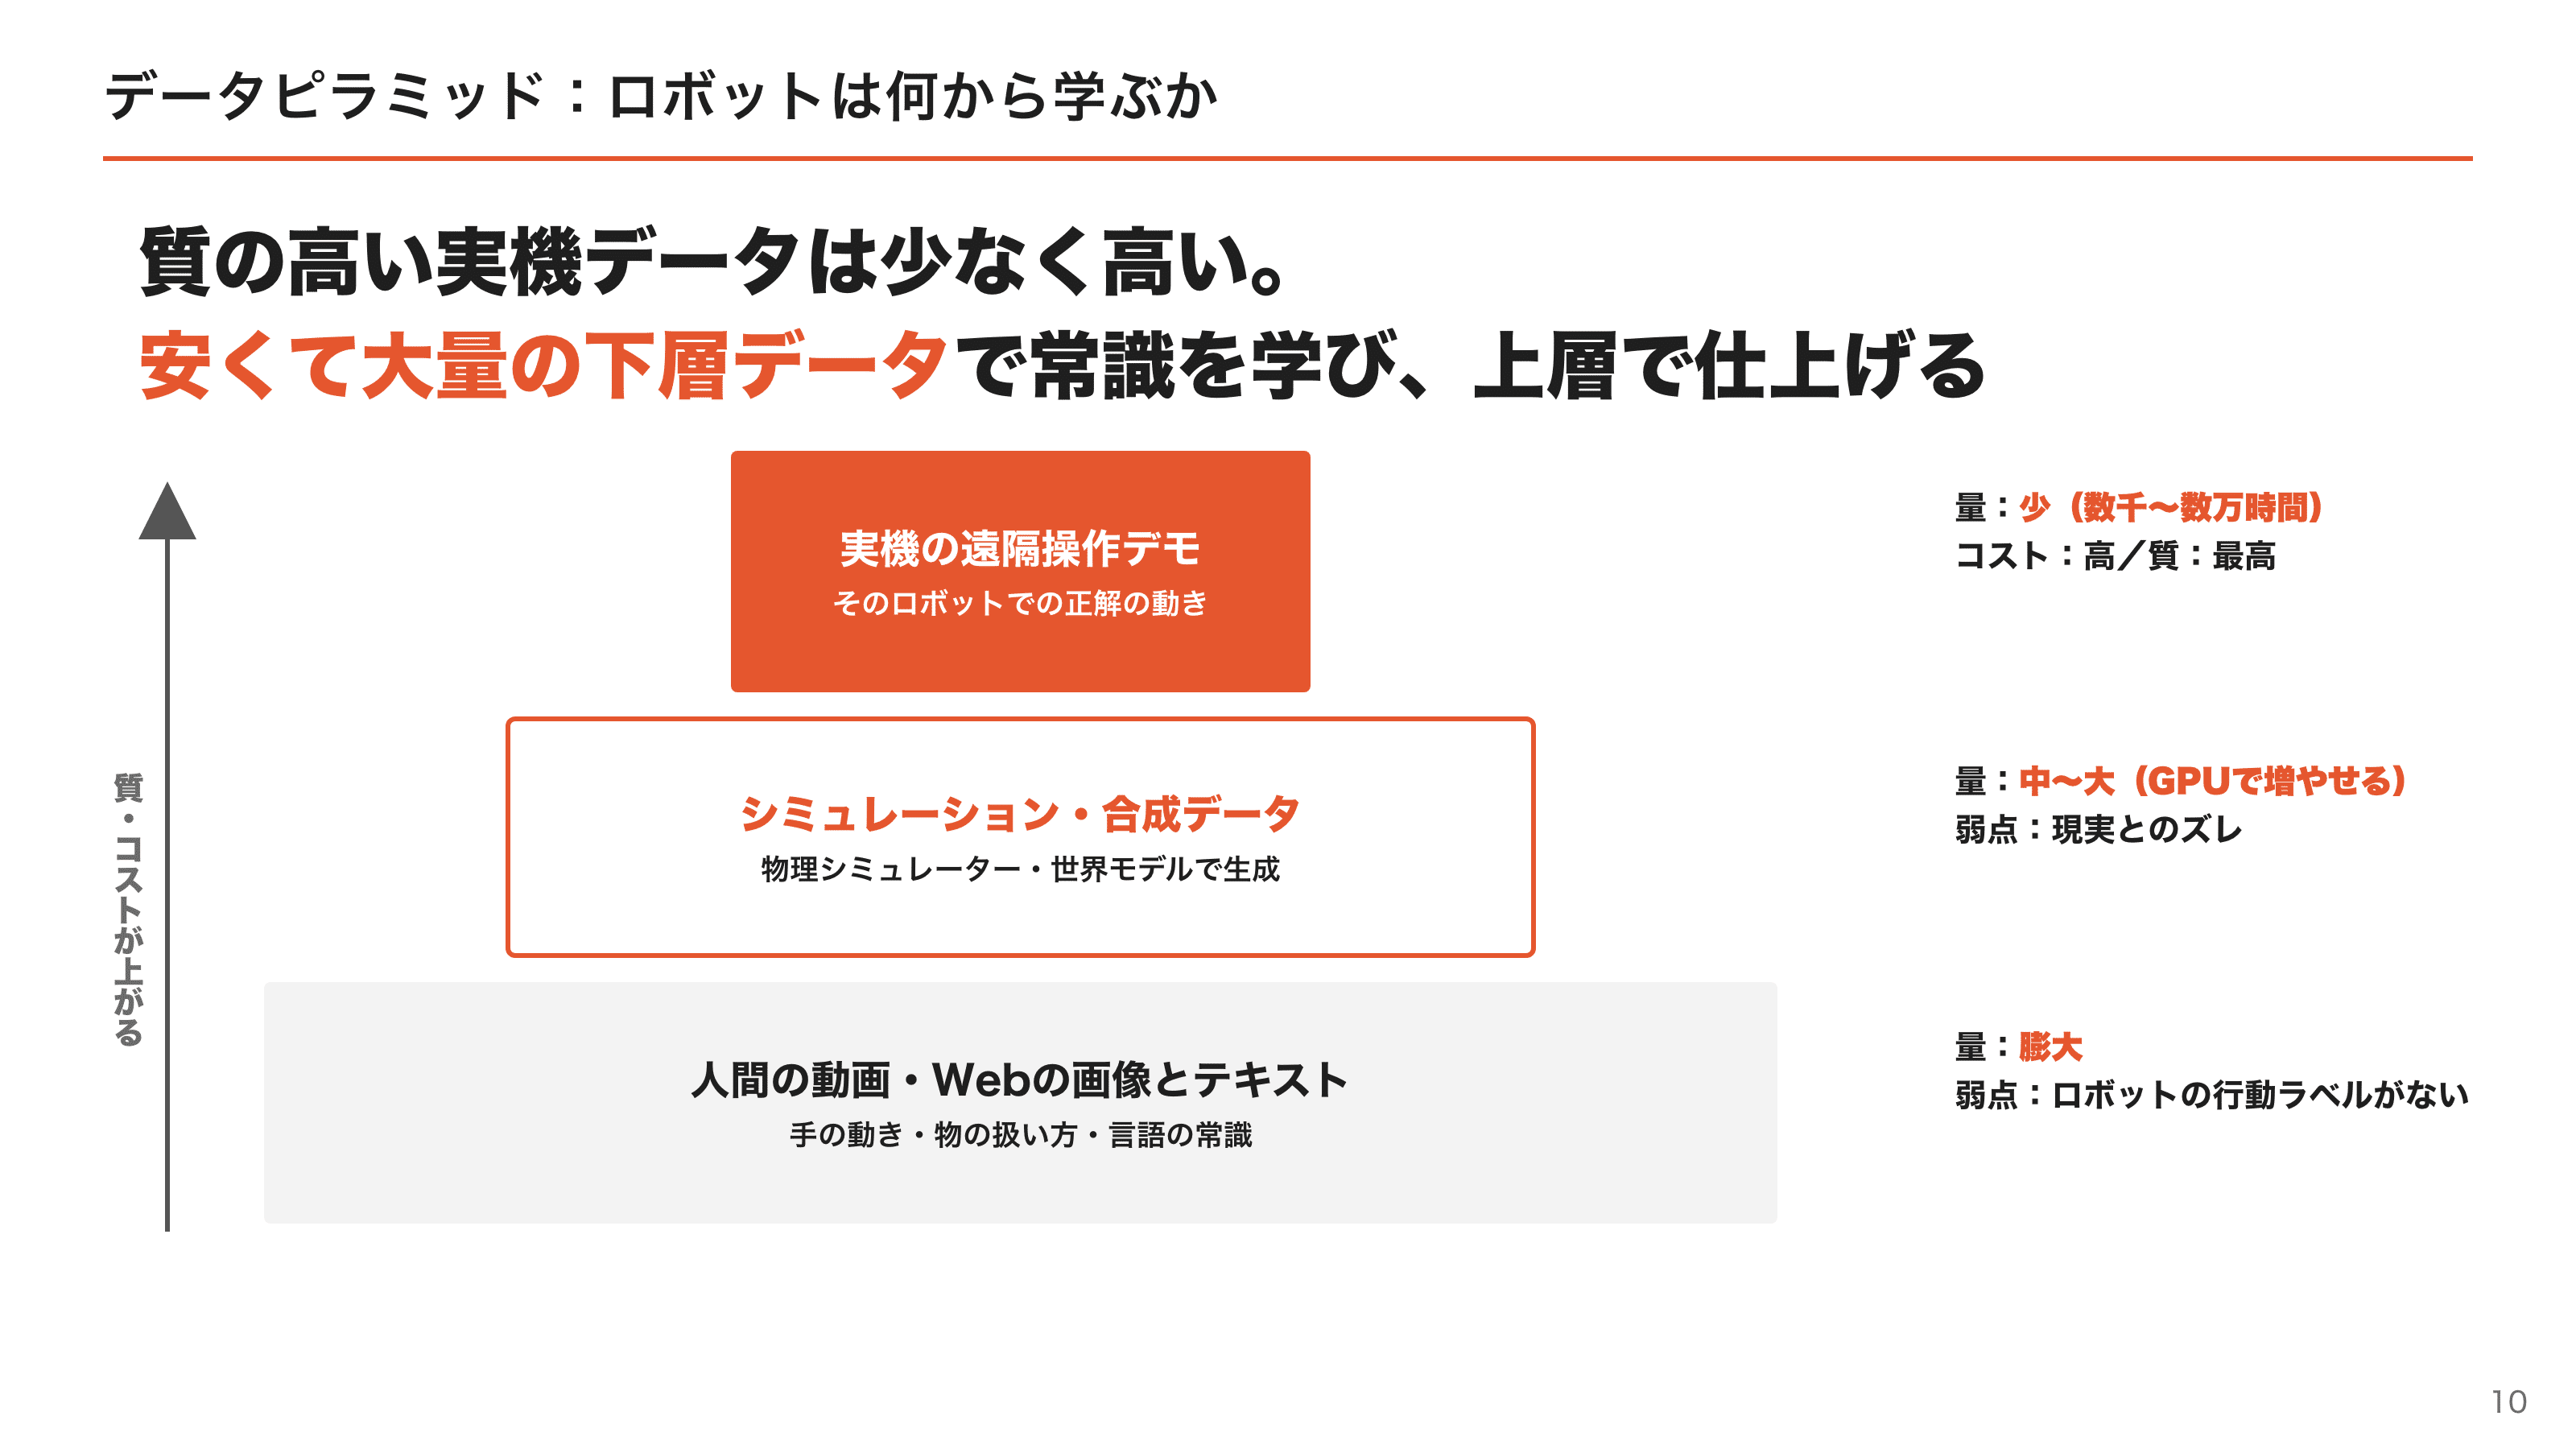
頂点:実機の遠隔操作データ
対象のロボットで実際に作業した、最も質の高いデータです。ただし、オペレーター1人が1時間操作して得られるのは1時間分のデータだけです。Physical Intelligenceのπ0系は1万時間超、TRIの大規模行動モデルは約1,700時間の実機データで事前学習されています。LLMのデータ量と比べると桁違いに少ない量です。
効率化の工夫として、ロボットを使わずにデータを集める方法も広がっています。代表例がUMI(Universal Manipulation Interface、2024年)で、GoProを付けた手持ちのグリッパーで人が作業し、その映像をロボットの学習データにします。ロボットを持ち運べない家庭や店舗でもデータを集められます。
中層:シミュレーションと合成データ
物理シミュレーターや世界モデルで生成するデータです。GPUを増やせばいくらでも作れますが、柔らかい物、液体、接触の多い作業では現実とのズレが大きくなります。
底辺:人間の動画とWebデータ
最も量が多いのは、人間が手を使って作業している動画です。弱点は「ロボットの関節をどう動かしたか」という行動のラベルがないことでした。2026年はここに大きな進展がありました。NVIDIAは2万時間超の人間の一人称動画(EgoScale)でGR00T N1.7を事前学習し、人間の動画の量を増やすほど性能が対数線形に伸びることを報告しています。前節のDreamZeroも、他のロボットや人間の動画だけのデモから学べることを示しました。
「人間の動画からロボットが学べる」が本格的に実証されつつあることは、Physical AIのスケーリングにとって最大のニュースです。YouTubeには人類が手を使って作業する動画が膨大にあります。これが使えれば、LLMがWebテキストで起こしたのと同じ規模の拡大がロボットでも起こり得ます。
LLM開発の知識はどこまで通用するか
3章の締めくくりとして、LLM開発の経験がある人向けに対応関係をまとめます。
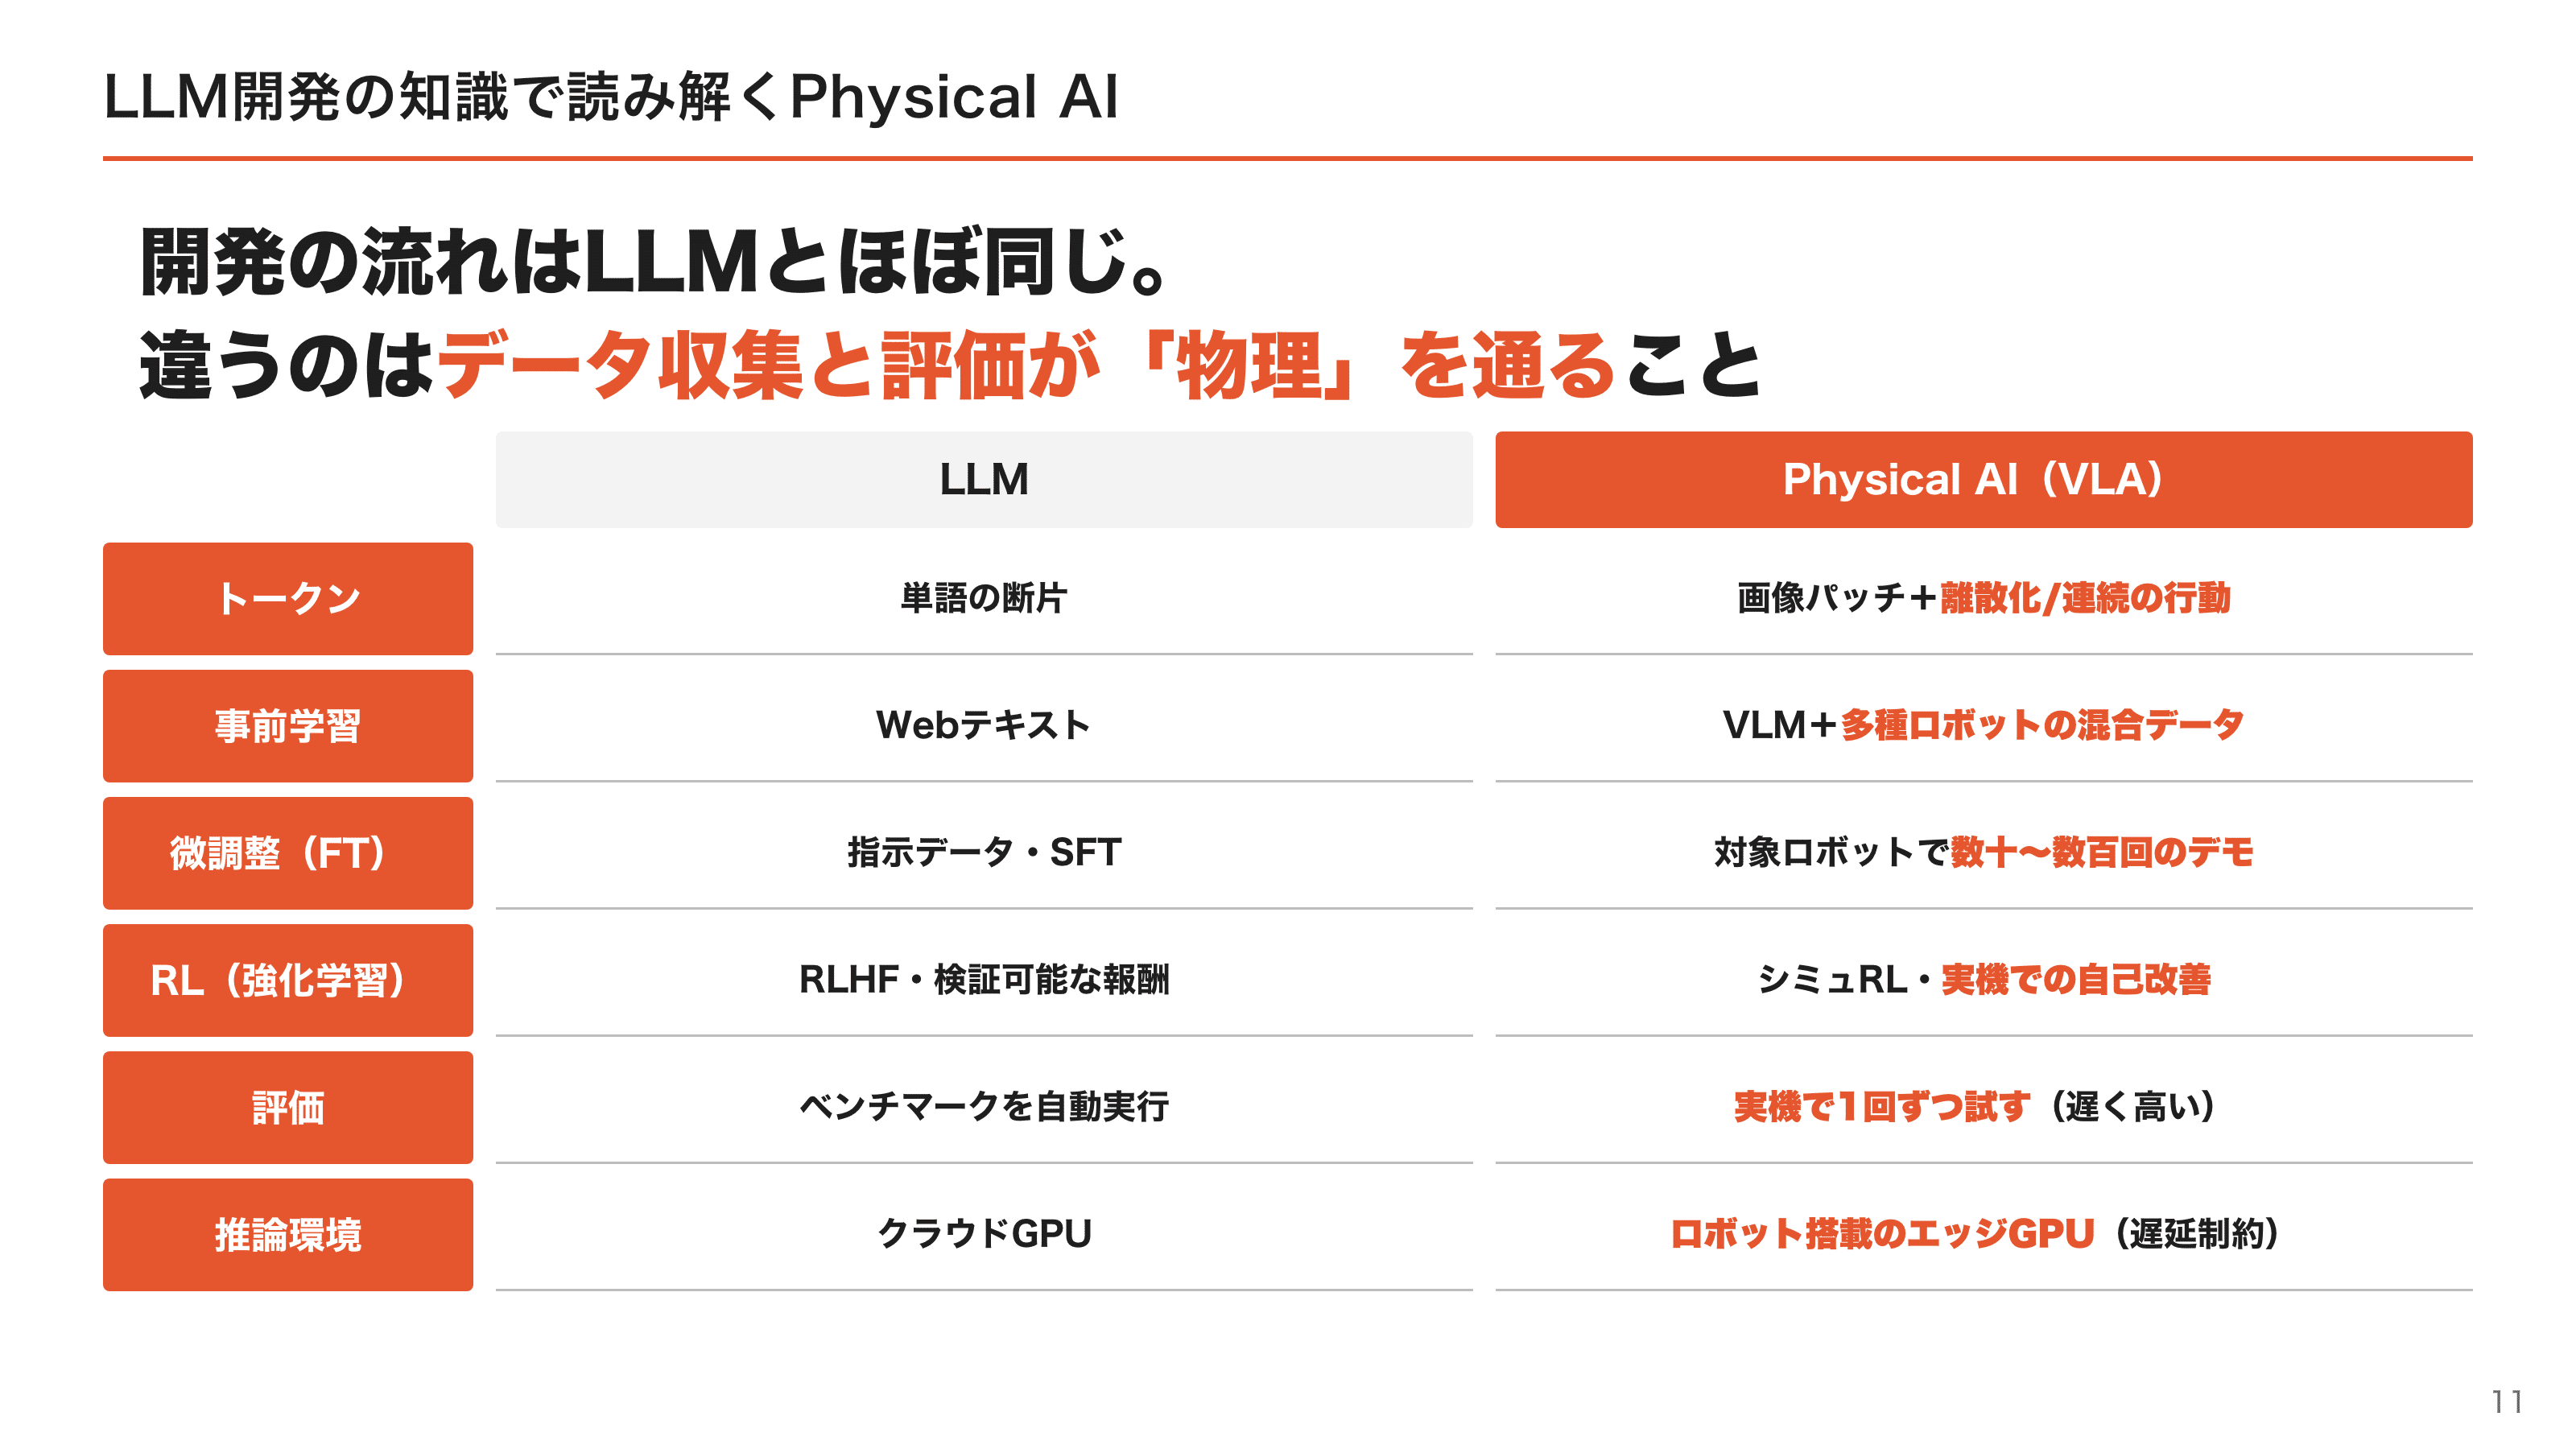
全体の流れ(事前学習 → 微調整 → 強化学習 → 評価 → デプロイ)はほぼ同じです。PyTorch、Transformer、Hugging Faceといった道具もそのまま使えます。
違いが大きいのは評価と推論環境の2点です。
評価:LLMはベンチマークを自動で数千問解かせて評価できますが、ロボットは実機で1回ずつ試すしかありません。1回数分かかり、環境のリセットも人手です。ここが開発速度のボトルネックになっており、世界モデルによる評価が注目される理由でもあります。
推論環境:モデルはロボット本体に載ったエッジGPU(NVIDIA Jetson Thorなど)で、決められた周期内に推論を終える必要があります。モデルの軽量化と非同期推論(考えている間も前の行動チャンクを実行し続ける)が実装上の重要ポイントです。
4. 最前線のプレイヤー
3章の技術を、誰がどう事業にしているのかを見ていきます。
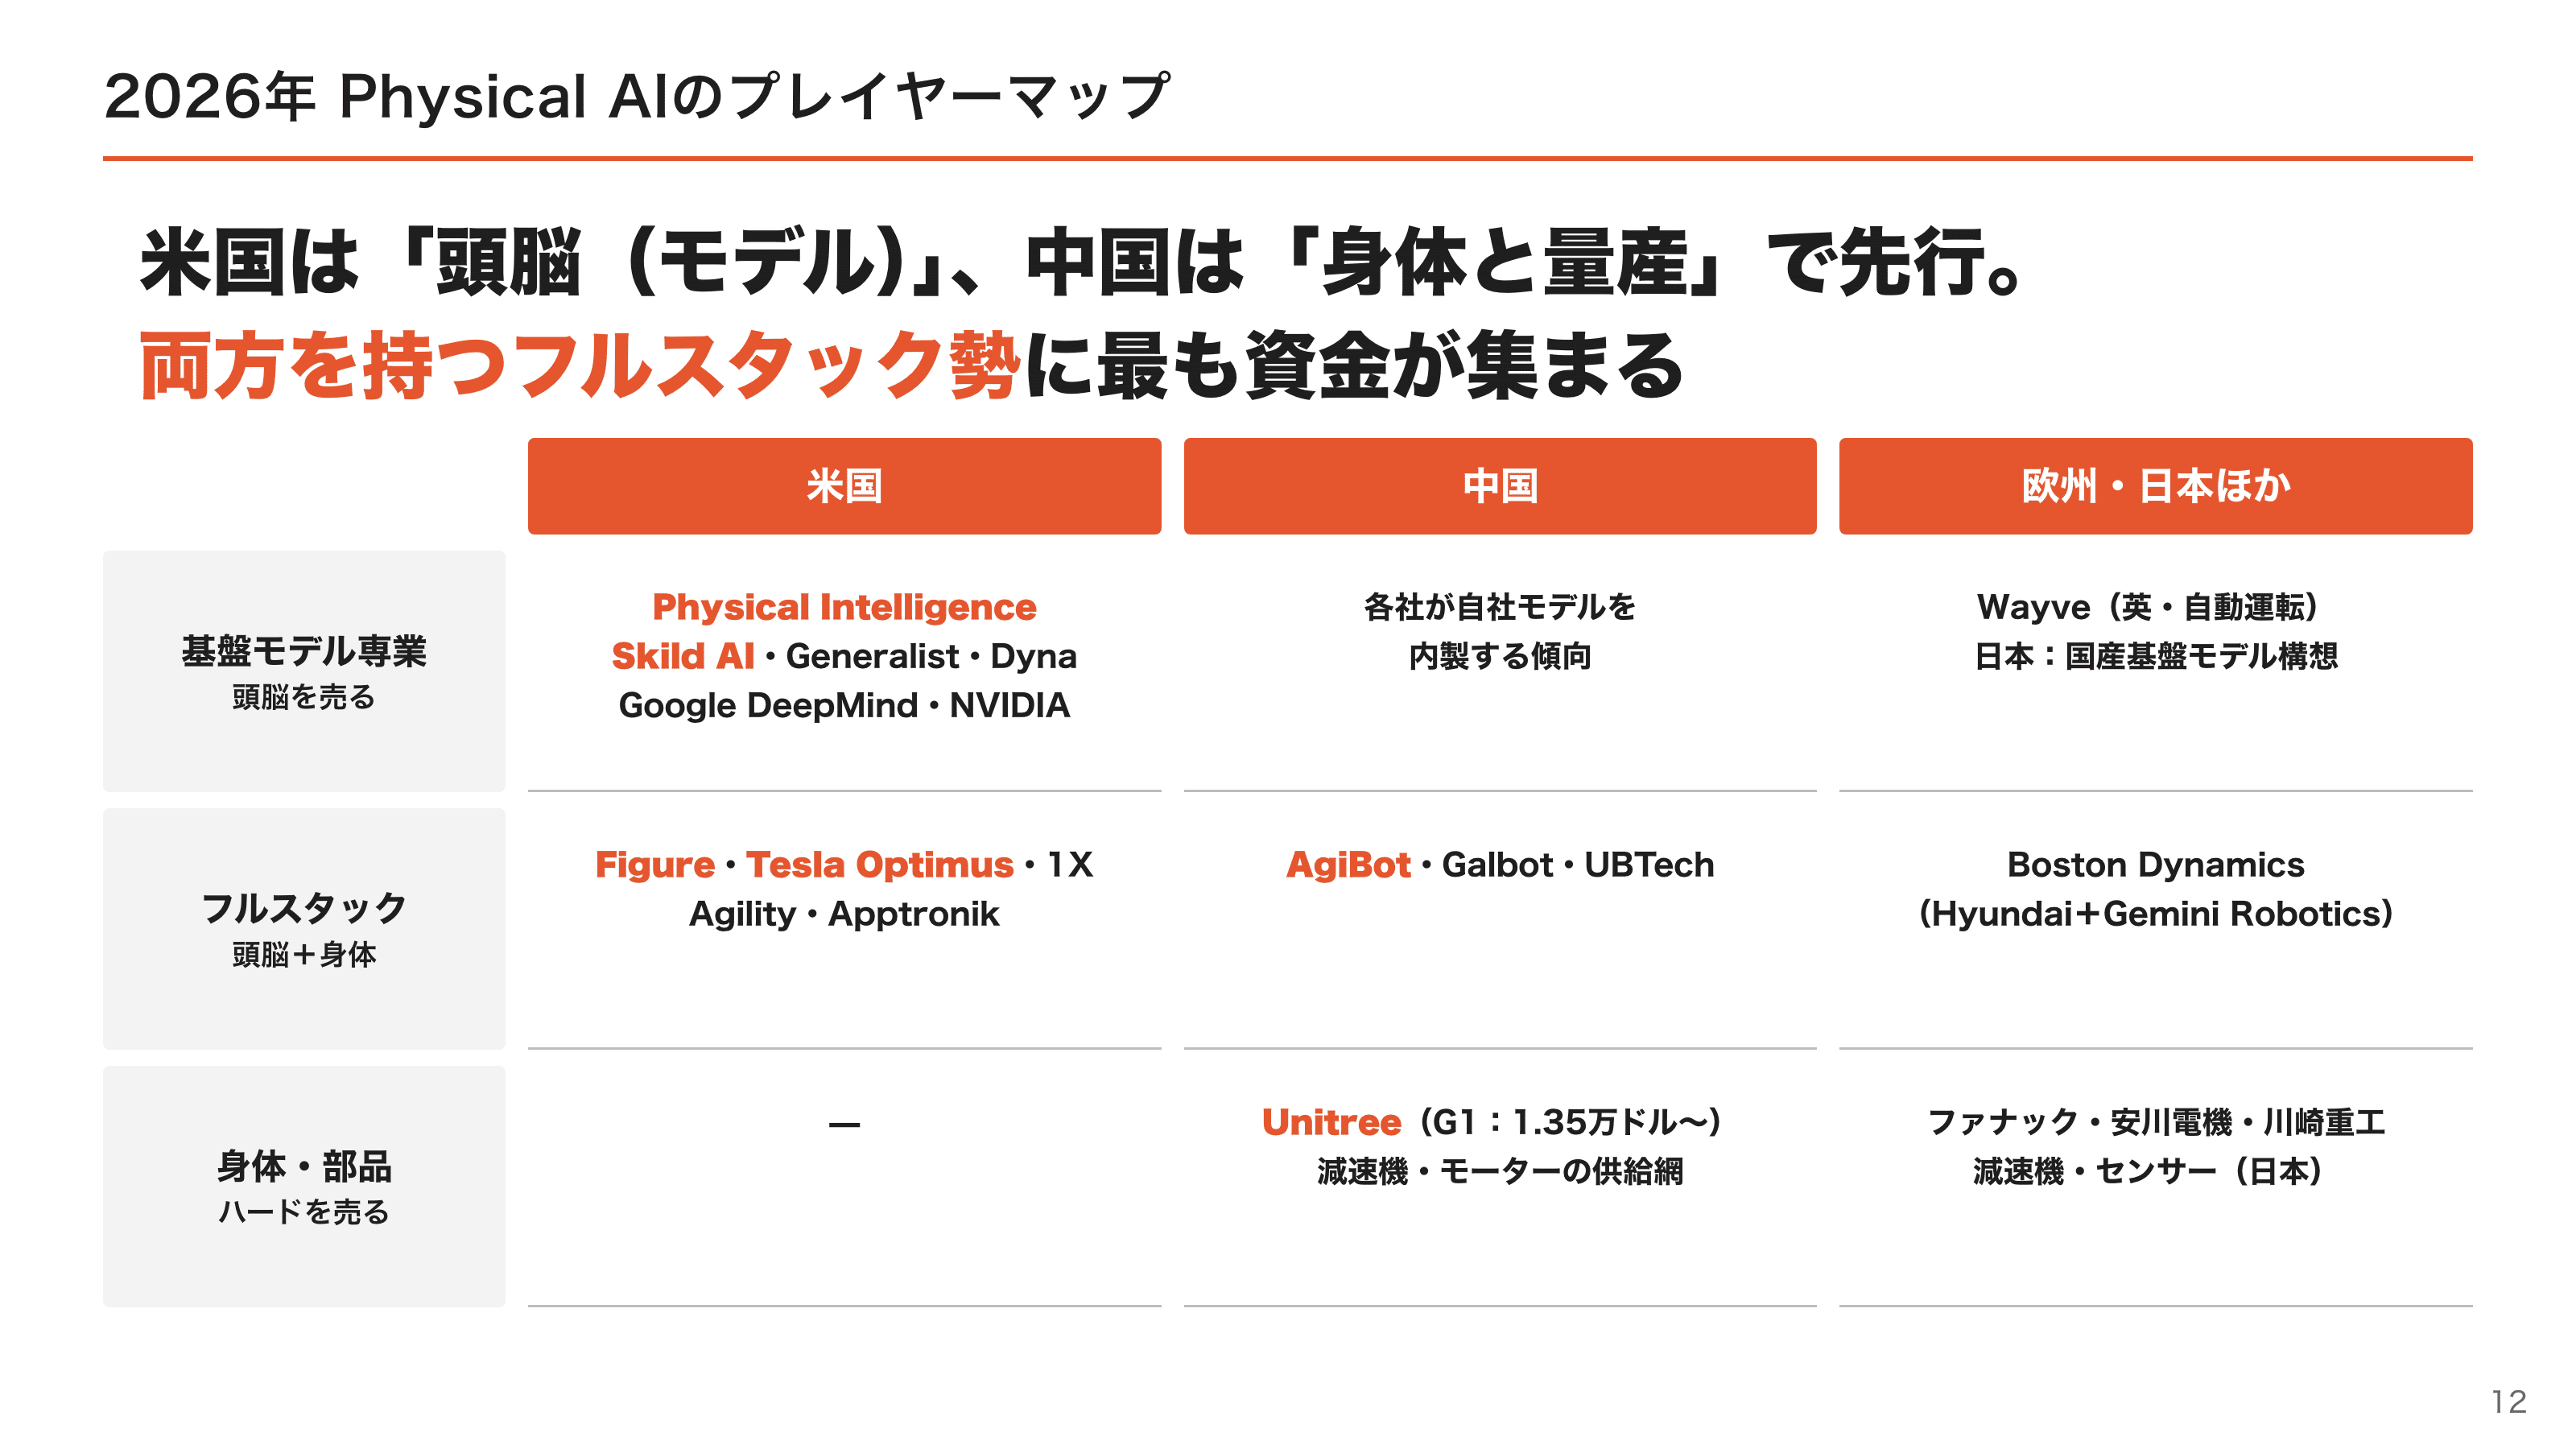
大きく分けると、頭脳(基盤モデル)を作る会社、頭脳と身体の両方を作るフルスタックの会社、身体(ハード・部品)を作る会社の3種類があります。地域で見ると、米国はモデルで、中国はハードの量産と価格で先行しています。
4.1 基盤モデル勢:「ロボットのOpenAI」を目指す
特定のロボットを作らず、どんなロボットにも載せられる頭脳を作る会社です。
Physical Intelligence(π)
Google DeepMindやスタンフォード大学の研究者が2024年に設立した会社で、3章で紹介したπ0〜π0.7を開発しています。2025年11月に評価額56億ドルで6億ドルを調達し、2026年10月には評価額約200億ドルでの追加調達を協議中と報じられています。2026年10月にはモデルの微調整と推論をクラウドで提供するPi APIのベータ版を公開しました。モデルを「API経由で使う」形が、ロボットでも始まりつつあります。
Skild AI
カーネギーメロン大学発のスタートアップです。2026年1月にソフトバンク主導で14億ドルを調達し、評価額は140億ドルを超えました。9月には、初の商用導入から約10か月で年換算売上(ARR)1億ドル超、有料顧客60社超に達したと発表しています(会社発表の数値)。基盤モデル専業で売上の数字を出した例として注目されています。
巨大テック
Google DeepMind:Gemini Roboticsを開発し、Boston DynamicsやApptronikと提携してモデルを供給しています。
NVIDIA:GR00T(モデル)、Cosmos(世界モデル)、Isaac(シミュレーター)、Jetson Thor(ロボット搭載用の計算機)をそろえ、「ロボットのAndroid」を狙っています。2026年3月のGTCでは「Physical AIは到来した。すべての産業企業はロボット企業になる」と宣言しました。
このほか、Generalist AI(2026年に評価額20〜30億ドル)、Genesis AI、Dyna Roboticsなど、2025〜2026年に設立・急成長したスタートアップが続いています。
LLMで起きた「基盤モデルを持つ少数の会社+それを使う多数の会社」という構図が、ロボットでも再現されるかが最大の論点です。ただし、ロボットは身体ごとに最適な動きが違うため、LLMほど一極集中しないという見方もあります。
4.2 ヒューマノイド:「人型」に巨額が集まる理由
人型ロボット(ヒューマノイド)は、Physical AIで最も資金と注目が集まる領域です。PitchBookによると、2025年のヒューマノイド企業への投資額は61億ドルで、前年の約4倍になりました。主要プレイヤーの2026年10月時点の状況をまとめます。
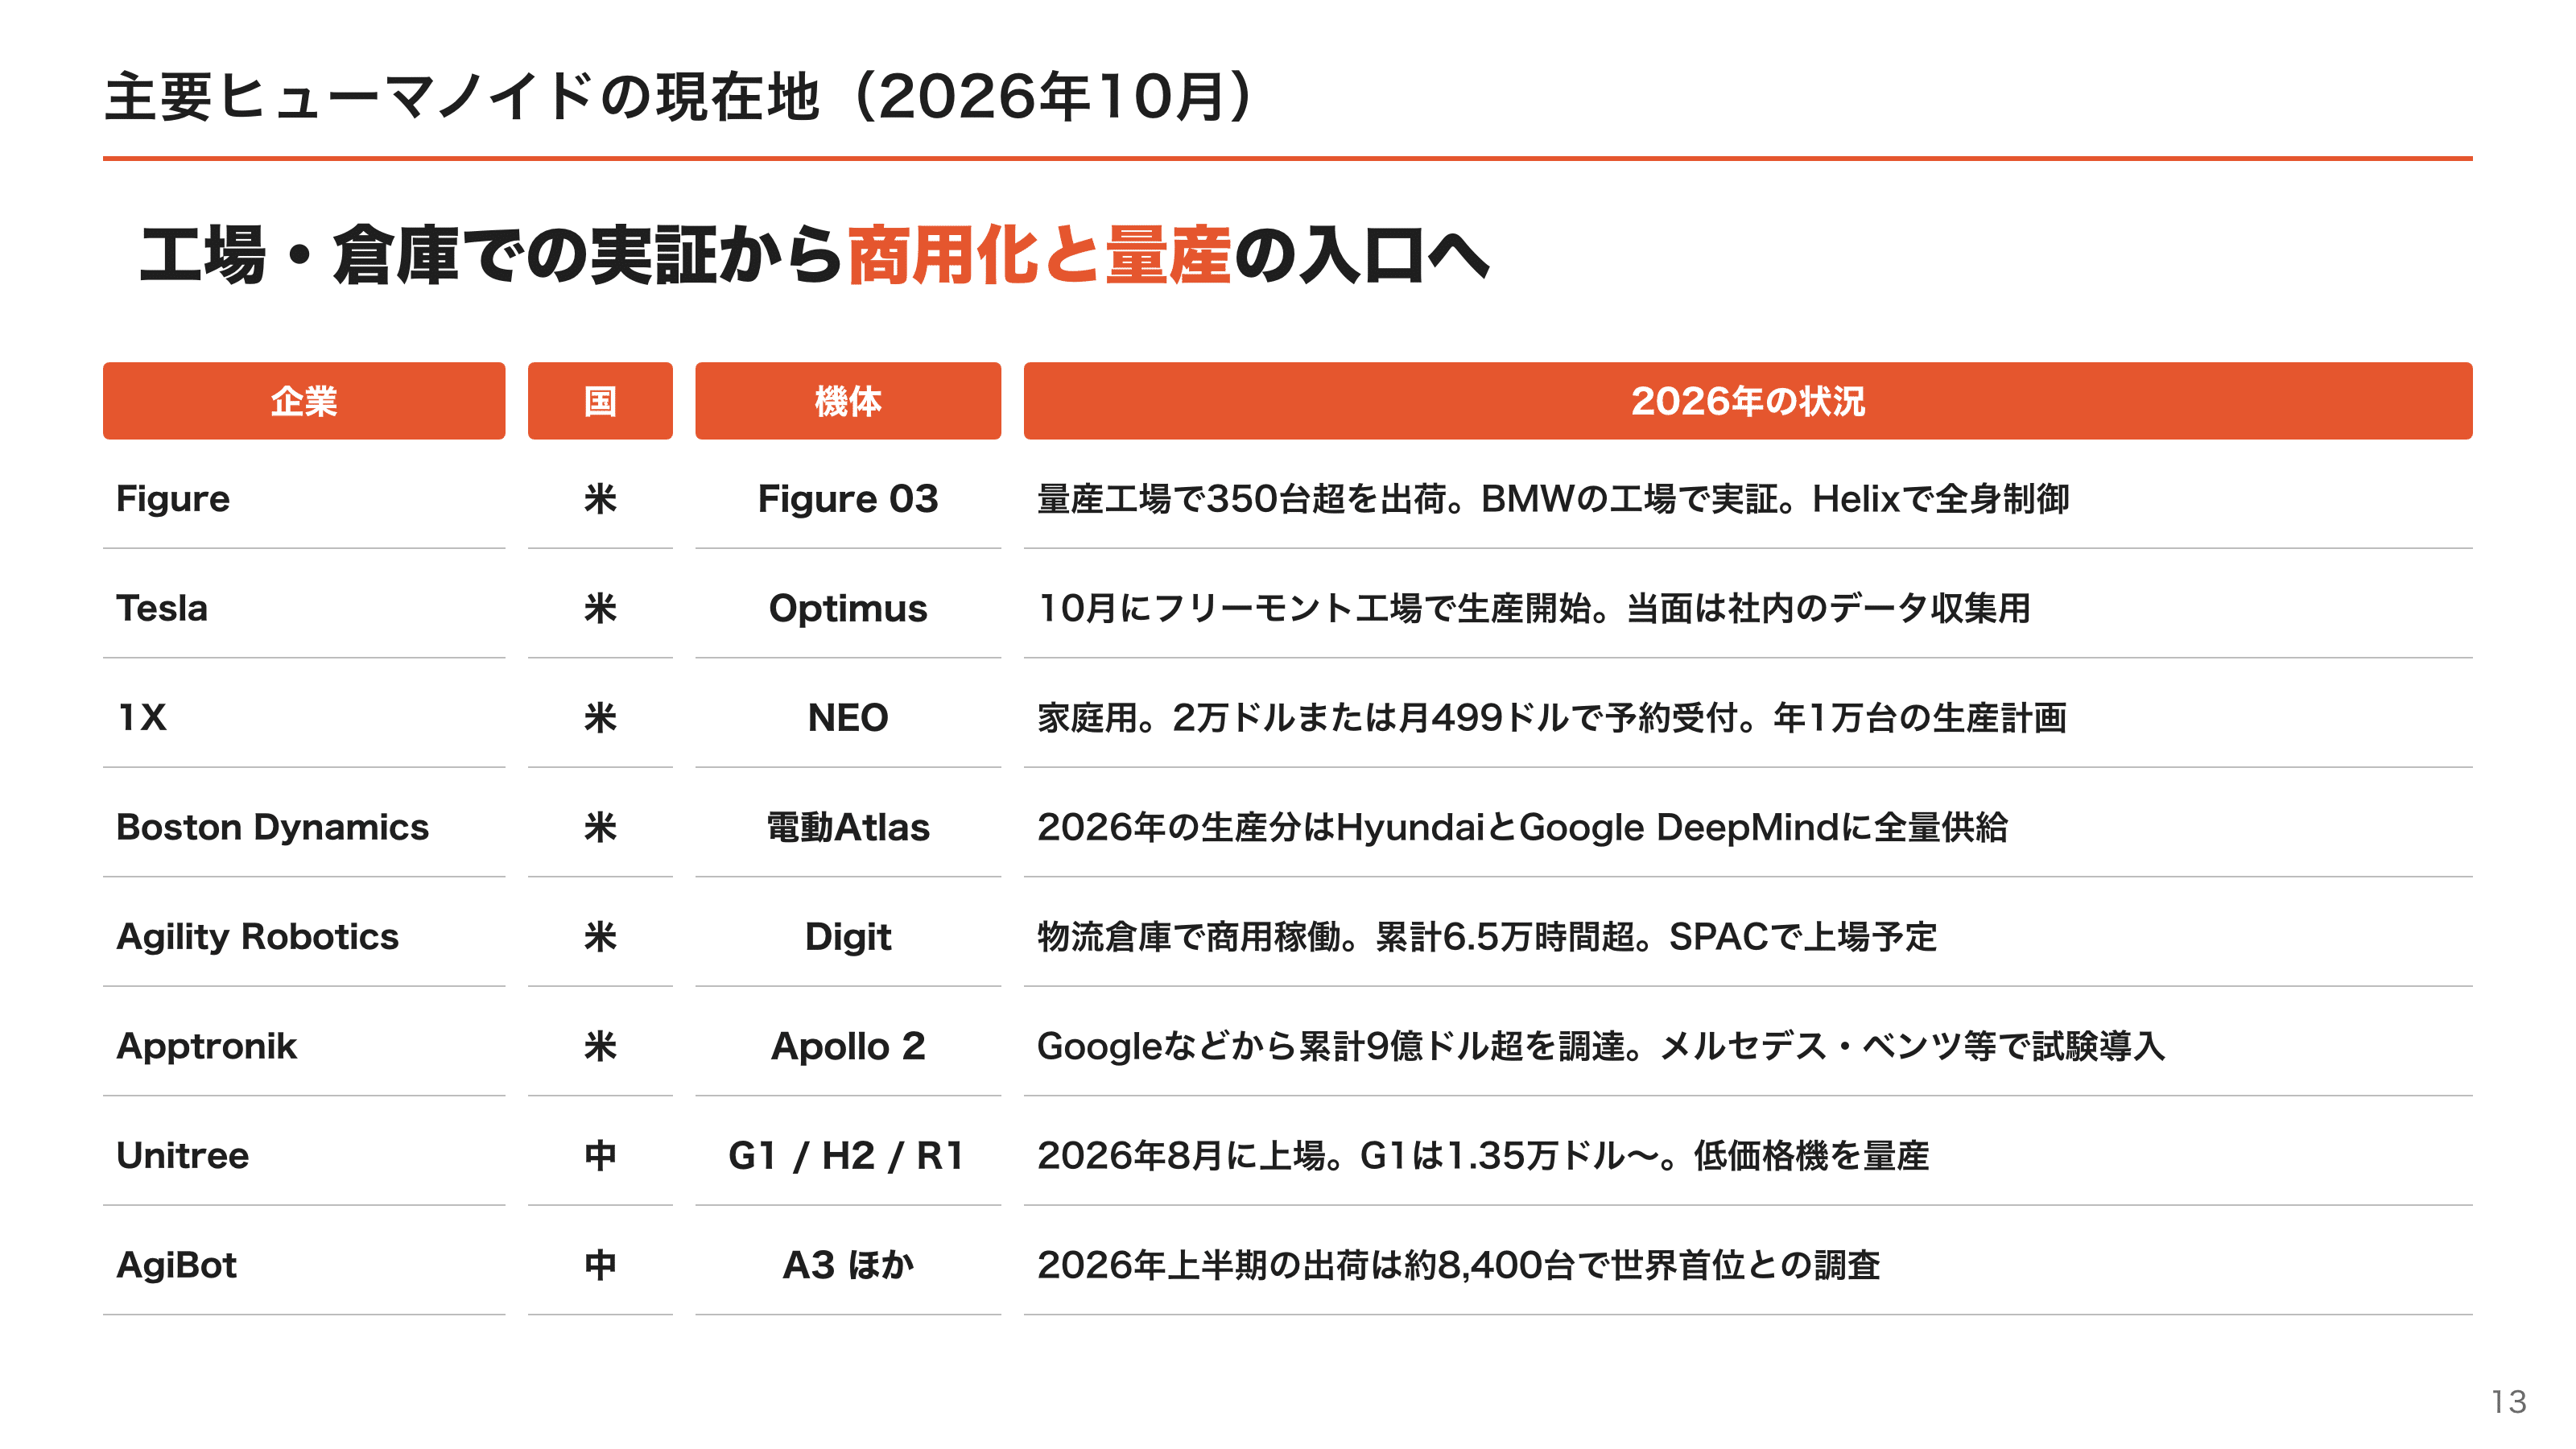
いくつか補足します。
Figureは2025年9月に評価額390億ドルで10億ドル超を調達した、ヒューマノイドの代表格です。旧機種のFigure 02はBMWの工場で約11か月稼働し、3万台のX3の生産に貢献したと発表しています。2026年5月には50時間連続で荷物を仕分けるライブ配信を行い、CEOは遠隔操作なしと説明しましたが、懐疑的な報道もありました。
Teslaは、Model S/Xの生産ラインをOptimus用に転換すると発表しています。将来の年産100万台を掲げていますが、2026年10月時点では生産立ち上げの初期段階です。
1X NEOは、家庭用ヒューマノイドとして初めて一般向けに予約を受け付けた機体です。自律でできない作業は、所有者の同意のもとで1Xのオペレーターが遠隔操作で補う仕組みが用意されています。「家庭用ロボットが家に来る」と「すべて自律で動く」は別の話だということを示す例です。
Boston Dynamicsは、2026年1月のCESで量産型Atlasを発表し、同時にGoogle DeepMindとの提携を発表しました。Hyundaiは2028年から米国工場で、部品を工程順に並べる作業(シーケンシング)にAtlasを使い始める計画です。
中国勢は量で先行しています。Unitreeは2025年の売上が前年比335%増で黒字でした。AgiBot、Galbot、UBTechも上場や上場準備を進めており、2026年の中国のロボット投資額は5月時点で前年の通年を上回りました(Crunchbase)。
ヒューマノイドの現在地は「工場や倉庫で、限定された作業の実証から商用化へ移りつつある」段階です。家庭で何でもこなす汎用ロボットにはまだ距離があります。
4.3 自動運転:最も進んだPhysical AI
自動運転は、最も商用化が進んだPhysical AIです。
Waymo(Alphabet傘下)は、2026年4月時点で週50万回超の完全無人の有料乗車を提供しています。米国15都市で展開し、累計の自動走行距離は3億マイルを超えました。2026年2月には評価額1,260億ドルで160億ドルを調達し、ロンドンでの試験走行も始めています。
Teslaは、2026年1月からテキサス州オースティンで、車内に安全監視員が乗らないロボタクシーを運行しています(遠隔監視あり)。
Wayve(英国)は、エンドツーエンドの学習型自動運転の代表格です。2026年2月に評価額86億ドルで調達し、日産の運転支援システムへの採用や、東京での試験も予定しています。
NVIDIAも2026年1月に、自動運転向けの推論型VLA「Alpamayo」を公開しました。自動運転とロボットは、カメラ映像から行動を出力するという点で同じ技術の上に乗りつつあります。
自動運転は、Physical AIが「デモ」から「毎週数十万人が使うサービス」になるまでに何が必要だったかを示しています。Waymoの場合、それは十数年の開発と、膨大な走行データ、慎重な段階的拡大でした。ヒューマノイドも同じ道をたどると考えられます。
4.4 日本:「第三極」を狙う官民の動き
生成AIでは米中に大きく後れを取った日本ですが、Physical AIについては2026年に官民の動きが一気に具体化しました。背景にあるのは、ロボットの部品と現場の強さです。産業用ロボットのファナック、安川電機、川崎重工、精密減速機のハーモニック・ドライブ・システムズやナブテスコなど、ロボットの身体を支える企業が日本には集積しています。
政策
AIロボティクス戦略(2026年3月):2040年に国内で約1,000万台のAIロボットを導入し、世界市場60兆円のうち20兆円を獲得して、米中に並ぶ「第三極」になる目標を掲げました。
骨太方針2026(2026年7月21日閣議決定):「フィジカルAIの構築を軸とするAX」を成長の加速装置と位置づけました。
NEDO「FRONTia」(2026年6月採択):AIロボットを見据えたマルチモーダル基盤モデルの開発事業。2026〜2030年度の計画で、Noetraと産総研が採択されました。
GENIAC(ロボット基盤モデル):経産省・NEDOの生成AI開発支援プログラムにロボット枠が設けられました。2026年9月のキックオフには、Telexistence、Preferred Networks/Preferred Robotics、SB Intuitions、メルカリ、KDDI、日立建機、東大発のHighlandersなど13チームが参加しています。
企業連携
Noetra(2026年7月):ソニー、ソフトバンク、NEC、ホンダを中核に44社・団体が出資する国産基盤モデル会社です。2030年度に「実世界ネイティブAI」の開発を目指し、約2万7,500基のNVIDIA GPUで計算基盤を構築する計画です。
NVIDIA Cosmos Coalitionの日本展開(2026年7月):ファナック、安川電機、川崎重工、富士通、ホンダ、ソニー、日立、Mujin、Telexistenceなど20社超が参加しました。同時に、富士通・ファナック・安川電機・川崎重工の4社がPhysical AIの共同事業の検討開始を発表しています。
データと研究
AIロボット協会(AIRoA):早稲田大学の尾形哲也教授が理事長を務める団体です。トヨタの生活支援ロボットHSR 44台、5拠点で集めた約5,000時間の遠隔操作データ(AIRoA MoMa 5k)を2026年7月に公開し、それを使ってπ0.5を追加学習したモデルも公開しました。国産のロボット基盤モデルは2027年6月頃にオープンソースでベータ版を出す計画です。
スタートアップ:倉庫向けのロボット制御で実績を持つMujinは「日本スタートアップ大賞2026」で内閣総理大臣賞を受賞しました。Telexistenceは、コンビニの商品の袋詰めを遠隔操作なしの単一VLAで実行する成果を発表しています。
日本の戦略は「基盤モデルで米国と真っ向勝負」ではなく、ハードと現場のデータを握ることに重心があります。工場・物流・介護など、実際にロボットが働く現場のデータは日本企業の手元にあります。これをモデルの性能に変えられるかが、今後数年の勝負どころです。
5. 未解決の課題とデモ動画の見方
残っている5つの課題
データ:3.5で見たとおり、人間の動画や世界モデルで緩和が進んでいますが、実機データは依然として高価です。LLMのような「データを増やせば性能が上がる」法則が、ロボットでどこまで成り立つかはまだ検証途中です。
評価:ロボットの性能を公平に比べる共通のベンチマークが確立していません。各社は自社で選んだタスクで「成功率○%」を発表するため、数字の比較が困難です。実機で数百回試すコストも障壁です。
信頼性:デモで90%成功するモデルは、工場では使えません。1日に1,000回作業すれば100回失敗するからです。産業用途で求められるのは99.9%以上で、最後の数%を詰める作業が最も難しいとされています。
安全性:人の近くで動く数十kgの機械が、学習モデルの予測できない振る舞いをしたときにどう止めるか。従来の産業用ロボットは柵で人と隔離していました。人と同じ空間で働くロボットの安全規格は整備の途中です。
ハードウェア:モーター、減速機、ハンドの耐久性とコスト。特に5本指ハンドは壊れやすく、毎日8時間の稼働に耐えるものはまだ少数です。
デモ動画を見るときのチェックリスト
Physical AIのニュースは主に動画で流れてきます。動画は印象が強い分、実力を読み違えやすい媒体です。次の6点を確認してください。
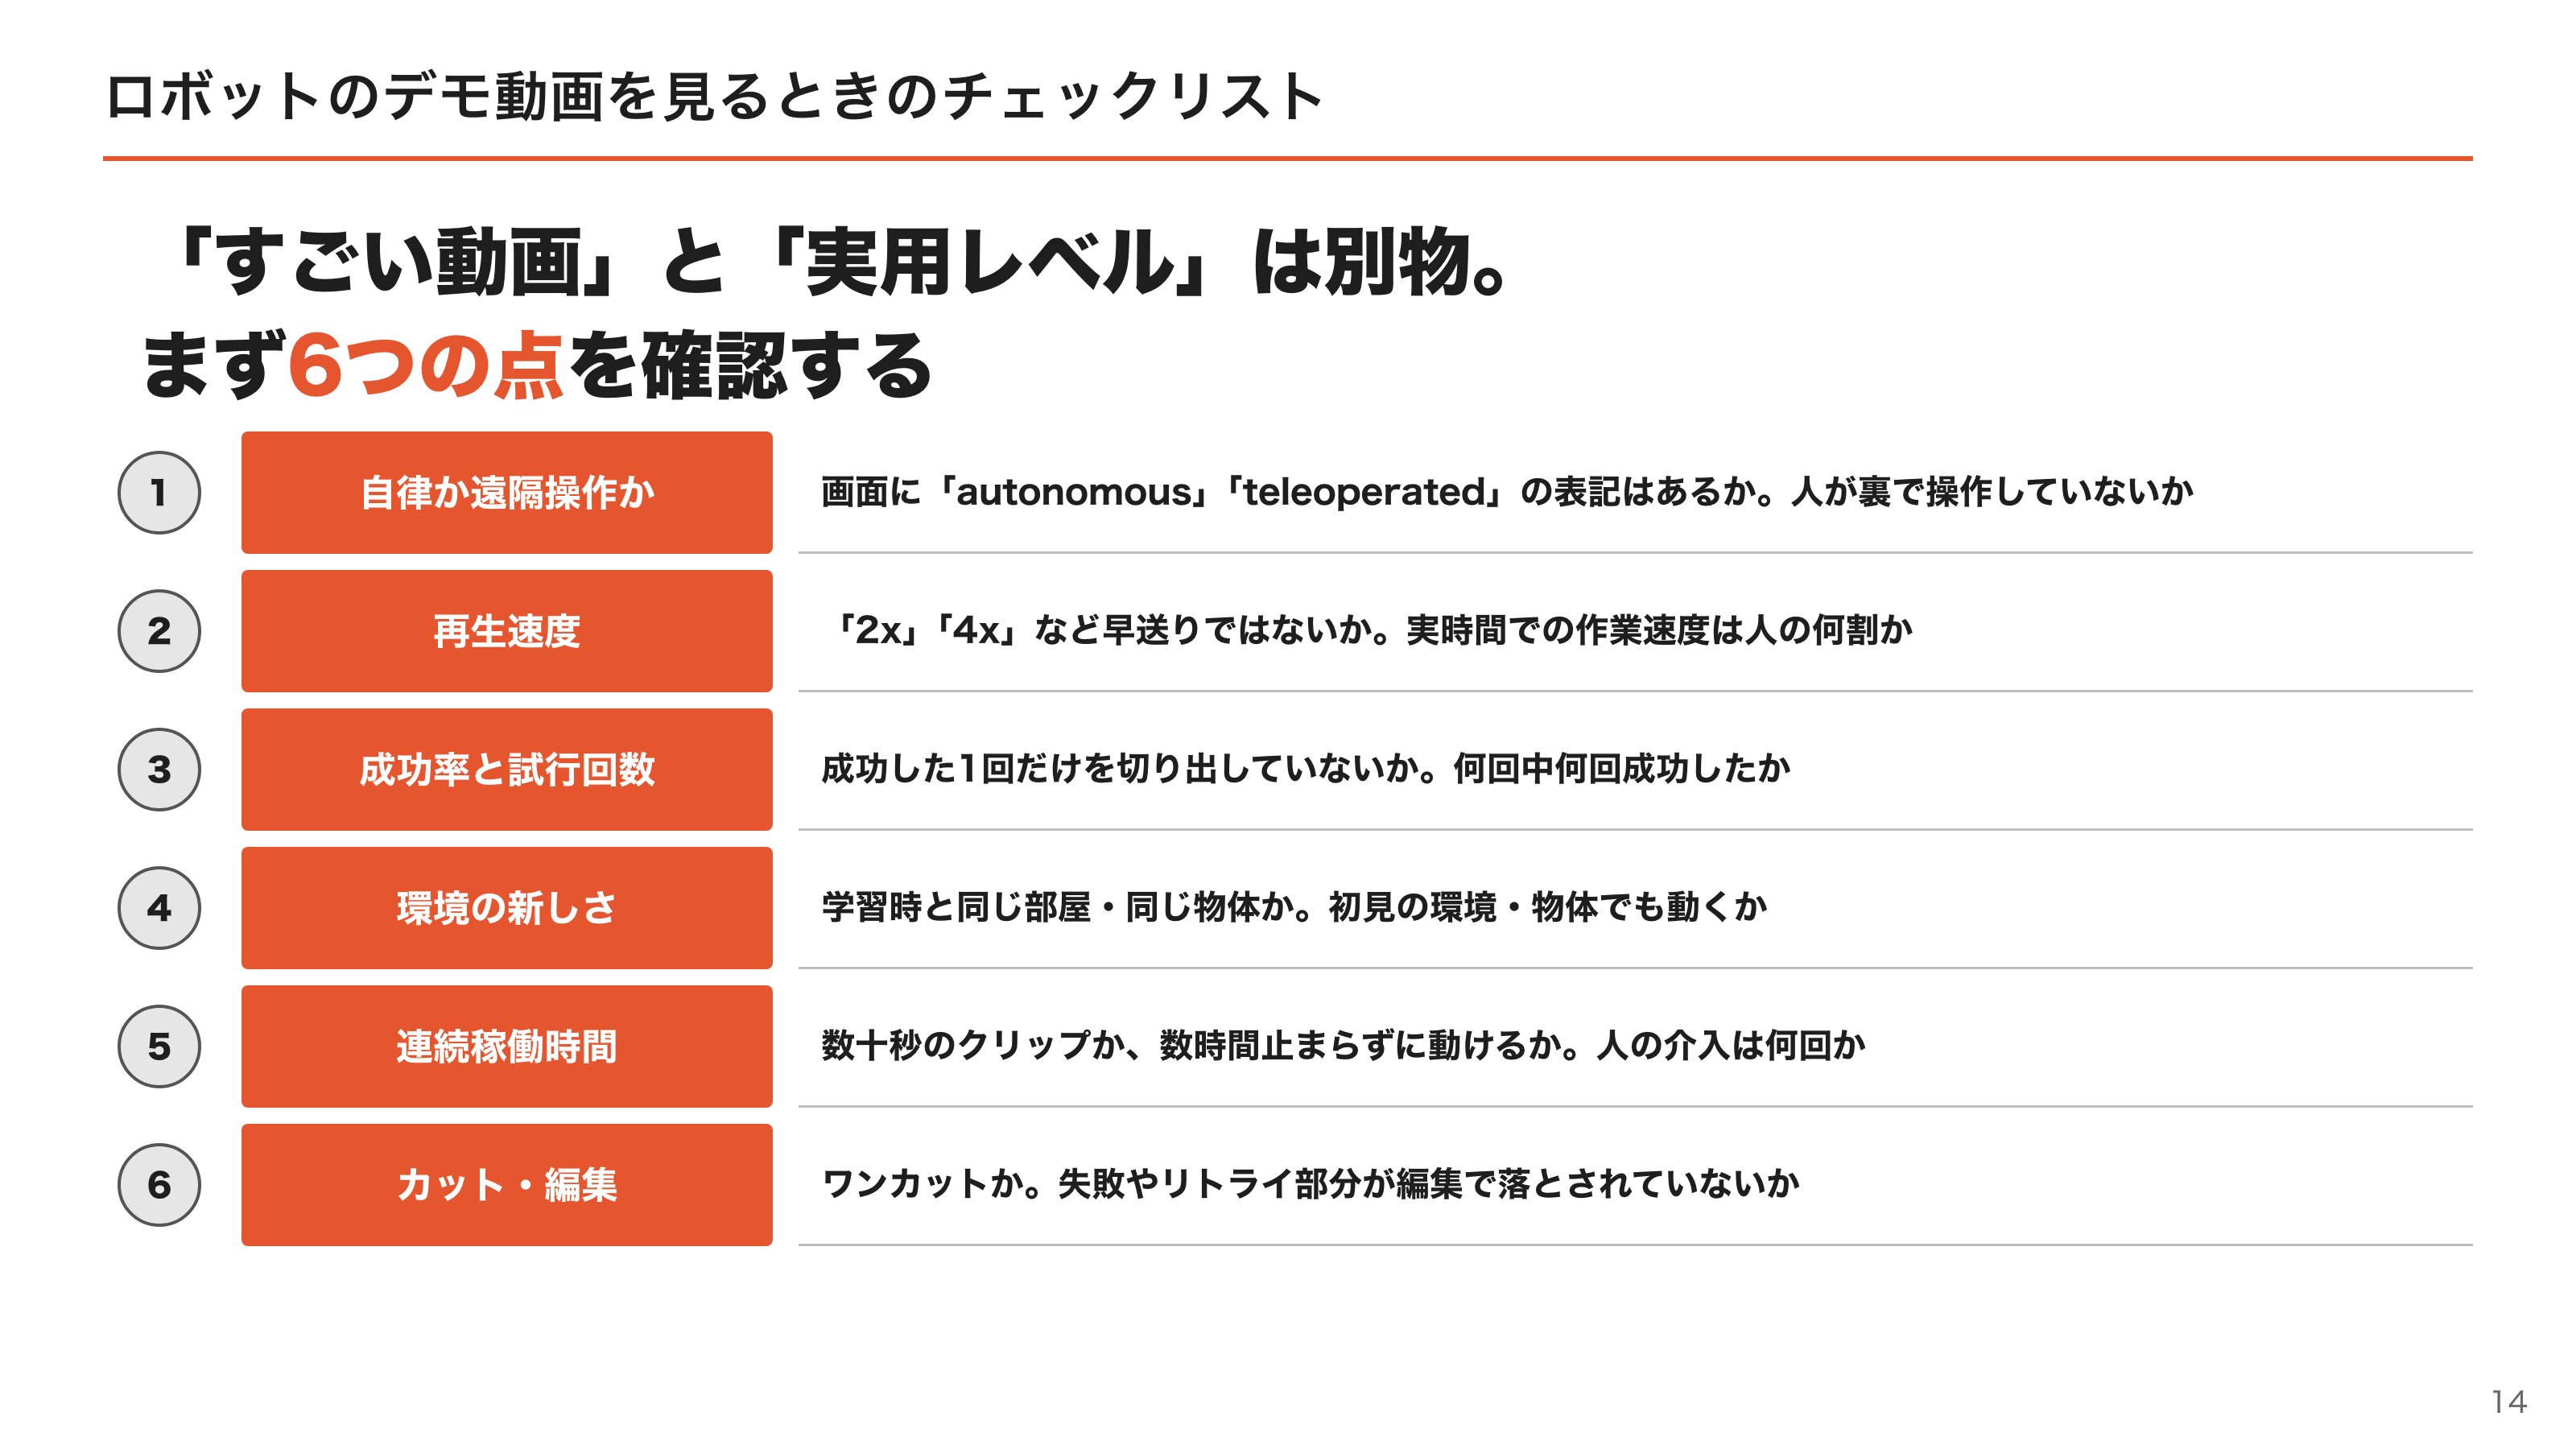
特に重要なのは1つ目の自律か遠隔操作かです。遠隔操作で動いているロボットの動画は、「ハードウェアがその動きをできる」ことを示しますが、「AIがその動きをできる」ことは示しません。誠実な企業は動画内に「autonomous(自律)」「teleoperated(遠隔操作)」「1x(等速)」などを明記しています。表記がない場合は、まず疑ってかかるのが安全です。
課題の多くは「研究としては解けたが、製品として毎日動かすには足りない」種類のものです。逆に言えば、評価・安全・運用といった地味な工程にこそ、ソフトウェア開発者が貢献できる余地が大きく残っています。
6. 開発者はどこから始めるか
2026年時点では、数万円のロボットアームと一般的なGPUがあれば、VLAの微調整まで個人で体験できます。
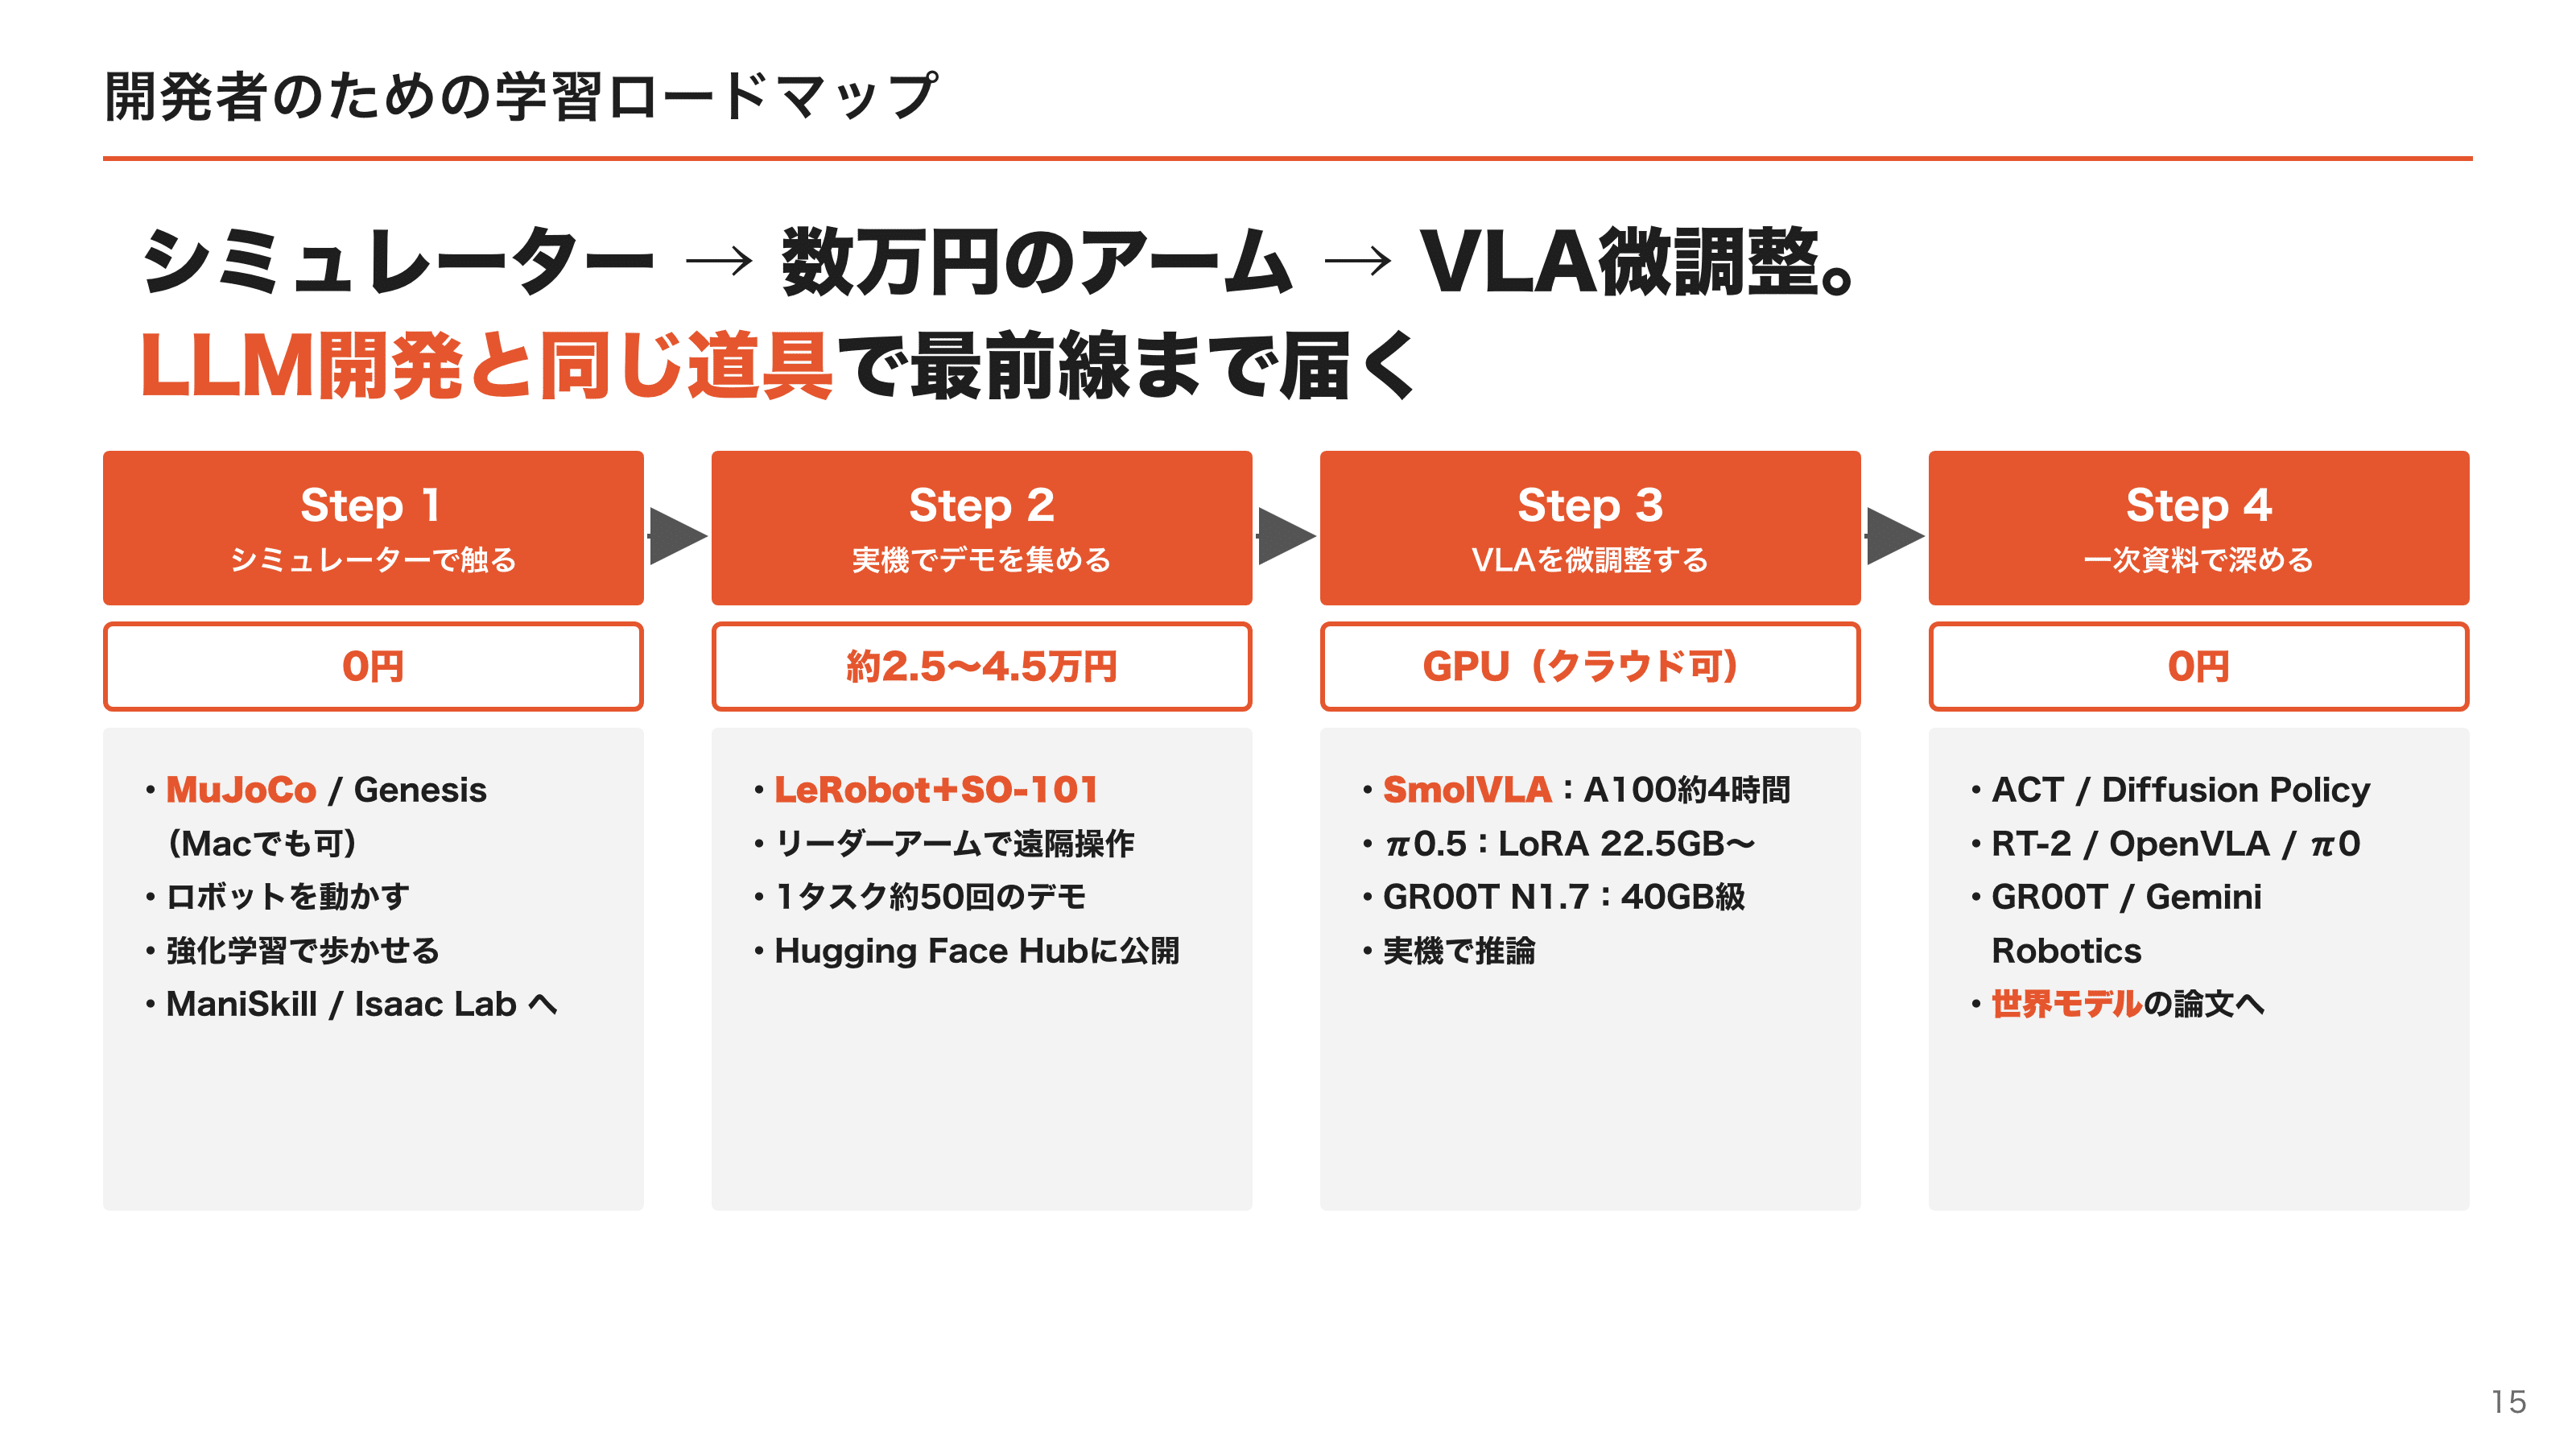
Step 1:シミュレーターで触る(費用0円)
まずはロボットを買わずに、シミュレーターでロボットを動かしてみます。
MuJoCo:Google DeepMindの定番物理エンジン。軽量で、CPUで動きます(Mac可)。まず触るならこれです。
Genesis:Pythonネイティブで高速な物理シミュレーター。Apple Metal・CPU・NVIDIA GPUに対応します。
ManiSkill 3:物体操作のベンチマーク環境。GPUで大量並列に動かせます(Linux+NVIDIA GPU)。
Isaac Lab:NVIDIAのロボット学習フレームワーク。強化学習の本命です(NVIDIA GPU推奨)。
いずれも無料・オープンソースです。MacならMuJoCoかGenesisから始めるのが手軽です。
Step 2:LeRobotとSO-101で実機を動かす(約2.5〜4.5万円)
LeRobotは、Hugging Faceが開発するロボット学習用のオープンソースライブラリです。データ収集、学習、実機での推論までを統一したコマンドで扱え、ACT、Diffusion Policy、π0/π0.5、SmolVLA、GR00Tなど主要な手法が実装されています。データセットとモデルはHugging Face Hubで共有できるので、LLMの開発に慣れた人にはなじみやすい作りです。
LeRobotで標準的に使われるのが、オープンソースのロボットアームSO-101です。
部品はサーボモーター(STS3215)と3Dプリント部品で構成されます。
公式の部品表では、操作用のリーダーアームとロボット側のフォロワーアームの2本組で約4.5万円、フォロワーだけなら約2.4万円です(日本の販売店価格、3Dプリント部品を除く)。
秋月電子通商などで部品やキットを入手できます。
リーダーアームを手で動かすとフォロワーアームが同じように動くので、これが遠隔操作によるデモ収集になります。3.2で説明した模倣学習を、机の上で一通り体験できます。
Step 3:VLAを微調整する
SO-101で集めたデータを使って、オープンなVLAを微調整します。LeRobot公式ドキュメントのSmolVLAの手順は、次の流れです。
1つの作業(例:ブロックを箱に入れる)のデモを約50回記録する(25回では足りなかったと書かれています)
データセットをHugging Face Hubにアップロードする
事前学習済みのSmolVLAを微調整する(A100 1枚で約4時間。GPUがなければColabでも可)
学習したモデルでアームを動かす
より大きなモデルを試す場合、必要なGPUメモリの目安は次のとおりです(各公式リポジトリより)。
SmolVLA(4.5億パラメータ):推論は一般的なGPUで可。微調整はA100 1枚で数時間
π0/π0.5(openpi):推論は8GB以上。微調整はLoRAで22.5GB以上(RTX 4090など)、フルで70GB以上
GR00T N1.7:推論は16GB以上。微調整は40GB以上を推奨
注目の論文
ACT / ALOHA(2023):Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware https://arxiv.org/abs/2304.13705
Diffusion Policy(2023) https://arxiv.org/abs/2303.04137
RT-2(2023) https://arxiv.org/abs/2307.15818
Open X-Embodiment(2023) https://arxiv.org/abs/2310.08864
OpenVLA(2024) https://arxiv.org/abs/2406.09246
π0(2024) https://arxiv.org/abs/2410.24164
GR00T N1(2025) https://arxiv.org/abs/2503.14734
Gemini Robotics(2025) https://arxiv.org/abs/2503.20020
Cosmos World Foundation Model Platform(2025) https://arxiv.org/abs/2501.03575
Learning to Walk in Minutes Using Massively Parallel Deep RL(2021、sim2realの強化学習) https://arxiv.org/abs/2109.11978
Physical AIは、ソフトウェア開発者が数万円で最前線と同じ道具に触れられる珍しい分野です。π0やGR00Tといったトップ企業のモデルが公開され、同じライブラリで自分のロボットに載せられます。
7. まとめ
Physical AIは「センサー入力から行動を出し続けるループ」のAIです。生成AIとの違いは、失敗のコスト、時間制約、そしてデータ不足にあります。
技術の中心はVLA(VLM+高速な行動生成の2階建て)です。2026年の競争軸は、全身制御、実機での自己改善、そして世界モデルへ移りました。人間の動画から学ぶ流れが、データ不足を崩しつつあります。
産業としては、米国の基盤モデル勢とフルスタックのヒューマノイド企業、量産で先行する中国、ハードと現場を握る日本という構図です。自動運転は週50万回の無人乗車に達し、ヒューマノイドは工場・倉庫での実証から商用化へ移りつつあります。
今後半年で注目したいのは、次の4点です。
NVIDIAが年内公開を予告しているGR00T N2(世界行動モデル)が、実際にどこまで汎化するか
Physical IntelligenceのAPIのように、ロボットの頭脳をAPIで使う形がどこまで広がるか
1X NEOをはじめとする家庭用ヒューマノイドの出荷が実際に始まるか
日本のAIRoAやNoetraが、現場データを強みにしたモデルを出せるか
VRプロフェッショナルアカデミーについて
私たち「VRプロフェッショナルアカデミー」(運営:株式会社VRデザイン研究所)は「AIと空間を実装するエンジニア」の育成と、XR・AIを使った企業向けの開発に取り組んでいます。
「人の技能を、ロボットの知能へ」:3D技能キャプチャーシステム Qoocan
記事の3.5節で紹介したとおり、Physical AIの最大のボトルネックは「人がどう動いたか」という質の高いデータです。
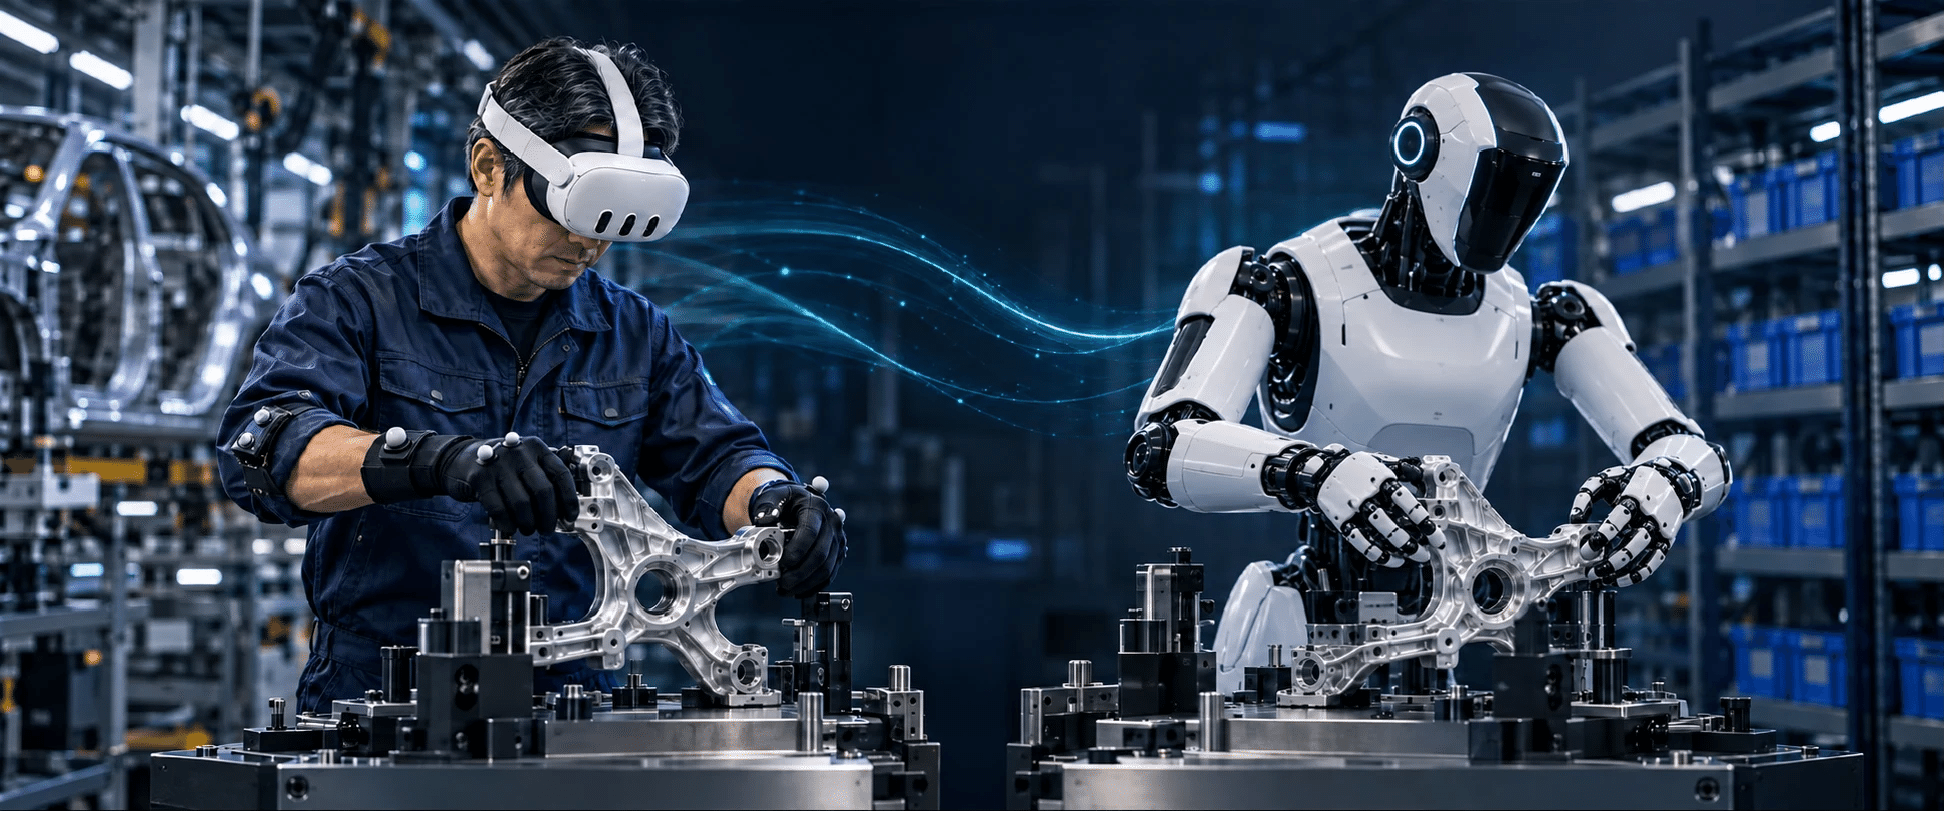
Qoocan(クーキャン) は、Meta Quest 3を装着するだけで、熟練者の身体と指1本ずつの動き、作業者視点の映像を記録するシステムです。コントローラーで手がふさがらないので、実際の工具を使ったいつもの作業をそのままデータにできます。
記録した動作をNVIDIA Isaac Simで再生し、人の動きをロボットの関節の動きに変換
Isaac Labで模倣学習・強化学習を行い、Sim-to-Realで実機ロボットへ展開
技能伝承や作業標準化、手順書づくりなど、人材育成にも活用
現在、日総工産株式会社と共同で開発中で、デモ・PoC(実証実験)のご相談を受け付けています。製造、物流、電子・精密機器、プラント、医療・介護などの現場で、熟練技能のデータ化やロボット活用を検討している方は、お気軽にお問い合わせください。
▶ Qoocanの詳細:https://vracademy.jp/qoocan/
企業向け:受託開発・研修
受託開発:XR(VR/MR)ソフトウェアやUnityアプリの企画・開発、3DGS(3D Gaussian Splatting)による空間スキャンと活用
企業研修:Unity、Apple Vision Pro、HoloLens 2などを使ったXRアプリ開発研修を、1社単位で実施
▶ 企業研修:https://vracademy.jp/corporate-training/training/
▶ 3DGSスキャンサービス:https://vracademy.jp/3dgs-scanservice/
▶ お問い合わせ:https://vracademy.jp/contactus/
個人向け:XR×AIを学ぶスクール
Physical AIの開発では、シミュレーション、3D空間、センサー、遠隔操作といった「空間」を扱う技術が欠かせません。アカデミーでは、Unityと生成AIを使って、空間を実装するスキルを実践的に身につけられます。
XRベーシック(動画学習・毎週月曜開講):プログラミング未経験から始められる入門コース
VRエキスパート/ARエキスパート/XRプロフェッショナル(通学・4か月、2027年4月開講):Unity×生成AI×3DGS、Android XR、Unity国際認定資格の取得などを学ぶ実践コース
▶ コース一覧:https://vracademy.jp/course/
▶ オンライン無料カウンセリング:https://vracademy.jp/freesession/
▶ オープンキャンパス(xR体験会):https://vracademy.jp/opencampus/
「記事を読んで、自分でも手を動かしてみたくなった」という方も、「自社の現場でPhysical AIを試したい」という企業の方も、ぜひ一度ご相談ください。
X:https://twitter.com/vracademyjp


